数量方法 · 第 10 章
一元线性回归在金融中的应用(Applications of Simple Linear Regression in Finance)
CFA 一级 · 数量方法 · 第 10 章 · 约 1 小时 1 分钟
本章学习目标
- LOS 10.a 描述并解释一元线性回归(simple linear regression),用最小二乘准则(least squares criterion)估计回归系数。
- LOS 10.b 描述一元线性回归(simple linear regression)的假设,从残差中发现对假设的违背,评价拟合优度、系数检验和 ANOVA 结果。
- LOS 10.c 计算并解释预测值、估计标准误和预测区间,描述对数-线性、线性-对数和双对数三种函数形式。
- LOS 10.d 用超额收益率对市场风险溢价做一元线性回归,估计并解释 CAPM 贝塔系数及相关统计量。
模块 10.1
线性回归基础(Linear Regression Basics)
本章用最小二乘法拟合一元线性回归(simple linear regression),解释斜率和截距(intercept)的含义,并用残差(residual)图检查模型假设。之后用方差分析(analysis of variance, ANOVA)、估计标准误(standard error of estimate)、 和 F 检验(F-test)衡量拟合优度,对系数做检验,构造预测区间(prediction interval),在几种对数变换的函数形式(functional form)中做选择,最后用回归估计股票的 CAPM 贝塔系数(beta)。
LOS 10.a — 一元线性回归与最小二乘准则
用途与术语
一元线性回归(simple linear regression)用一个自变量(independent variable)的变动来解释一个因变量(dependent variable)的变动(variation)。变动指各观测值与均值之差的平方和,即 。它和方差(variance)相关,但不是一回事:方差是把变动除以 。
| 因变量(Y) | 自变量(X) | |
|---|---|---|
| 作用 | 被解释的变量 | 用来解释的变量 |
| 其他叫法 | 被解释变量、内生变量、被预测变量 | 解释变量、外生变量、预测变量 |
| 例:用国内生产总值(gross domestic product, GDP)增长预测股票收益率 | 股票收益率 | GDP 增长 |
一个因变量配一个自变量,叫一元回归;一个因变量配两个及以上自变量,叫多元回归(multiple regression)(二级内容)。
模型与回归线
核心概念
上面第一行是总体(population)模型,第二行是估计出的回归线,即最佳拟合线。字母上的帽子表示估计值。第 个观测值的残差(residual) ,是实际值与拟合线在该 X 处预测值之间的差。
- 考试惯例:残差、**误差项(error term)和扰动项(disturbance term)**视为同一个东西,都写作 。
- 现行做法:误差项 是总体模型中观测不到的偏差,残差是它的样本(sample)估计值。
最小二乘准则
散点图上可以画出无数条直线。**普通最小二乘法(ordinary least squares, OLS)回归选的是使误差平方和(sum of squared errors, SSE)**最小的那一条。SSE 的算法:把因变量每个观测值与其拟合值之间的竖直距离平方,再加总:
由此得到的估计值为:
核心概念
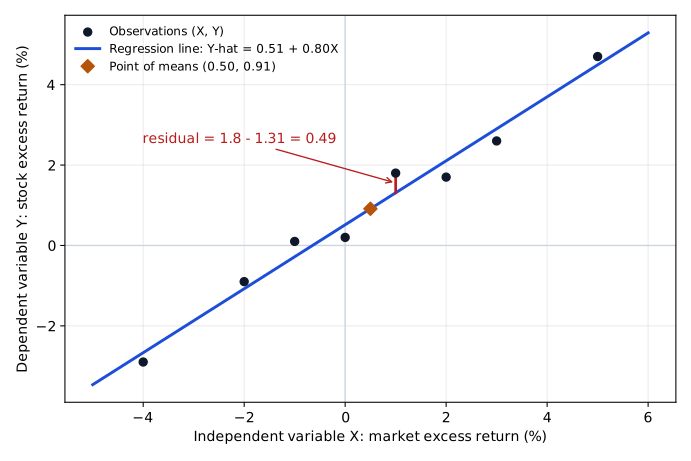
从截距(intercept)公式可以看出,回归线一定经过均值点 。协方差(covariance)和方差的分母都是 ,相除时约掉,所以直接用原始数据算斜率:。
例题详解
八个月度观测值给出 、、、(单位都是 %²)。对应的求和为 、,用 算出的斜率相同。
对 、 这个观测值:,残差为 。
系数的含义
- 斜率系数(slope coefficient) :自变量每增加一个单位,因变量预期变动多少。在上例中,市场超额收益率(excess return)每高 1 个百分点,股票超额收益率高 0.80 个百分点。如果 Y 是股票的超额收益率、X 是市场的超额收益率,斜率就是这只股票的贝塔系数(beta)。
- 截距(intercept) :X 等于零时 Y 的预测值(predicted value),也就是回归线与纵轴的交点。
- 斜率大并不说明关系强,显著性要靠检验判断(t 检验(t-test)或置信区间(confidence interval, CI))。
数据类型
核心概念
| 类型 | 定义 | 例子 |
|---|---|---|
| 时间序列(time series) | 同一变量按固定间隔在不同时间的观测值 | 一家公司五年的季度每股收益(earnings per share, EPS) |
| 横截面数据(cross-sectional data) | 同一时点许多对象的观测值 | 某指数 30 只成分股今天的收盘价 |
| 面板数据(panel data) | 在多个时点重复观测的横截面数据 | 10 家公司五年的季度 EPS |
常见考试陷阱
- 斜率是协方差(covariance)除以 X(自变量)的方差。除以 Y 的方差是常见错误。
- OLS 最小化的是 Y 的实际值与预测值之差的平方,不是比较系数或 X 值。
- 斜率是 X 每变动一个单位时 Y 的变动。理解成 Y 每变动一个单位时 X 的变动,就把两个变量的角色弄反了。
答题技巧
- 回归线经过 ,所以知道斜率后,截距直接用 算出,不必再求和。
本节要点
- 一元线性回归(simple linear regression)用单个自变量(independent variable) X 的变动,解释因变量(dependent variable) Y 的变动 。
- 普通最小二乘法选出使误差平方和(sum of squared errors, SSE) 最小的直线。
- OLS 估计值为 和 ,因此拟合线经过均值点。
- 斜率是 X 每增加一个单位时 Y 的预期变动;截距(intercept)是 X 等于零时 Y 的预测值(predicted value)。
- 残差(residual) 是实际值与拟合值之差。考试惯例把残差、误差项和扰动项看作同一个东西;现行做法把残差看作观测不到的误差项的样本估计值。
- 时间序列(time series)数据跟踪一个变量随时间的变化,横截面数据覆盖同一时点的许多对象,面板数据是在多个时点重复观测的横截面数据。
随堂小测
A credit analyst gathers data on 80 bond issuers at a single date to see whether an issuer's interest coverage ratio helps explain the yield spread on its bonds. In her simple linear regression, the dependent variable is:
查看答案和解析
正确答案: B
因变量(dependent variable)是模型要解释其变动的那个变量,这里是收益率利差(yield spread)。利息保障倍数(interest coverage ratio)用来做解释,所以是自变量(解释变量)。同一日期许多发行人(issuer)的观测值属于横截面数据,一元线性回归(simple linear regression)可以用横截面数据,和用时间序列(time series)数据一样。
其他选项为什么错
- A. 解释变量就是自变量。把利息保障倍数当作因变量,就把分析师研究问题所确定的角色弄反了。
- C. 同一时点许多对象的数据是横截面数据,可以做回归,不要求必须是时间序列数据。
本题要点 因变量(Y):被解释变量、内生变量、被预测变量。自变量(X):解释变量、外生变量、预测变量。哪个是哪个,由研究问题决定。
模块 10.2
方差分析与拟合优度(Analysis of Variance (ANOVA) and Goodness of Fit)
LOS 10.b — 假设、残差分析、ANOVA 与拟合优度
一元线性回归(simple linear regression)的假设
核心概念
- 线性(linearity):X 与 Y 之间是线性关系。
- 同方差性(homoskedasticity):每个观测值的残差(residual)方差相同。
- 独立性(independence):残差之间互不相关(各组 X–Y 观测值相互独立)。
- 正态性(normality):残差项服从正态分布。
假设是否被违背,看残差对 X(或对时间)的散点图。模型设定正确时,残差在零附近随机分布,看不出规律。
| 违背的假设 | 残差图的表现 | 名称 |
|---|---|---|
| 关系不是线性的 | 有系统性规律,例如随 X 增大,残差先正、后负、再正 | — |
| 残差方差不恒定 | 残差的离散程度随 X 变大(或变小),或随时间变化 | 异方差性(heteroskedasticity) |
| 残差相关 | 规律反复出现,例如每年 12 月误差都很大(季节性);此时系数方差的估计值是错的 | 自相关(autocorrelation) |
| 残差不服从正态分布 | 残差偏斜或尾部偏厚;小样本(sample)下假设检验可能不可靠(大样本时,根据中心极限定理(central limit theorem, CLT),估计结果可能仍然有效) | — |
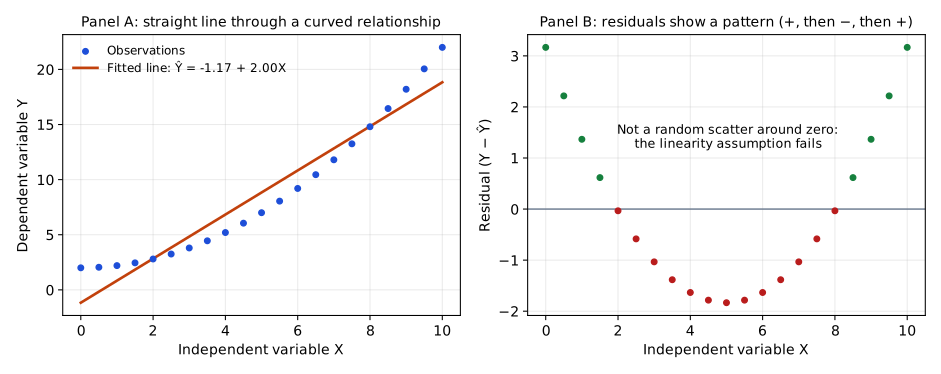
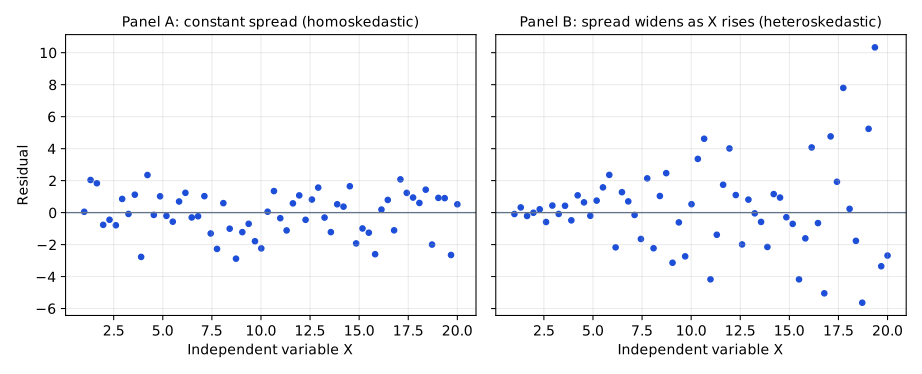
**异常值(outliers)**是离回归线很远(残差大)或 X 值远离其他观测的观测值。它们会把估计系数拉偏,使回归线对其他点拟合得很差。
方差分析(ANOVA)
**方差分析(analysis of variance, ANOVA)**把因变量(dependent variable)的总变动拆成已解释和未解释两部分:
- 总平方和(total sum of squares, SST) :总变动。
- 回归平方和(sum of squares regression, SSR) :回归解释的变动。
- 误差平方和(sum of squared errors, SSE) :未解释的变动(也叫残差平方和)。
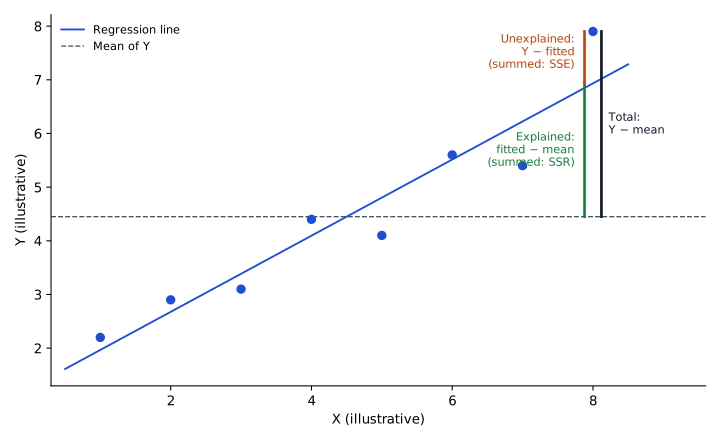
Y 的样本方差(sample variance)等于总变动除以自由度(degrees of freedom),即 。
- 回归均方(mean square regression, MSR) ;只有一个自变量(independent variable)时(),MSR = SSR。
- 均方误差(mean squared error, MSE) (一元回归)。
核心概念
| 变动来源 | 自由度 | 平方和 | 均方 |
|---|---|---|---|
| 回归(已解释) | SSR | MSR = SSR/1 | |
| 误差(未解释) | SSE | MSE = SSE/() | |
| 合计 | SST |
拟合优度指标
估计标准误(standard error of estimate, SEE)也叫均方根误差(root mean squared error),是残差的标准差(standard deviation)。SEE 越小,拟合越好。
核心概念
决定系数(coefficient of determination) 衡量因变量的总变动中有多大比例由自变量解释。一元回归中 ,所以相关系数(correlation coefficient) ,符号与斜率相同。如果只知道 和 SSR,可以先算 SST SSR,再算 SSE SST SSR,进而得到 MSE 和 SEE。
F 检验
F 检验把回归每个自由度解释的变动,与每个自由度未解释的变动相比较。比值大,说明相对于噪声(noise),自变量解释了很多变动。
**F 检验(F-test)**检验所有自变量作为一个整体能否解释 Y 的变动;有多个自变量时,原假设是所有斜率系数(slope coefficient)都等于零。只有一个自变量时,它检验 对 ,与斜率的 t 检验(t-test)是同一个假设。拒绝 的条件是 (这是单尾检验(one-tailed test),用 F 分布的右尾)。拒绝 说明 X 与 Y 之间存在显著的线性关系。
例题详解
;SSR = 64,SSE = 112,所以 SST = 176。MSE ;SEE ;;(斜率为正时);,远高于自由度为 1 和 28 时 5% 显著性水平下约 4.2 的临界值(critical value),所以斜率显著。
回归系数的 t 检验
检验显著性时,设 (双尾检验(two-tailed test)), 时拒绝。检验斜率等价于检验相关性(correlation),。只有一个自变量时,F 统计量等于这个 t 统计量的平方,所以 F 检验和斜率的 t 检验结论总是相同(上面的例题中, 对应 )。截距(intercept)也可以用同样方法检验()。
指示变量
指示变量(indicator variable)(虚拟变量(dummy variable))在某个条件成立时取 1,否则取 0(例如衰退(recession)季度取 1)。用 Y 对指示变量回归,可以检验这个条件是否有影响:斜率等于条件成立与不成立两类时期之间 Y 的均值之差,检验 等价于均值差检验。截距是条件不成立时(指示变量 = 0)Y 的均值,截距加斜率是条件成立时的均值。*例:*用公司季度盈利对衰退指示变量回归,可以检验盈利是否具有周期性;盈利有周期性时,斜率预期为负(衰退季度盈利较低)。如果扩张(expansion)季度的每股收益(EPS)平均为 1.40,衰退季度平均为 0.95,拟合线为 ,其中衰退季度 。
常见考试陷阱
- 。SSE/SST 是未解释的比例(),SSR/SSE 不是标准指标。上面的例题中, 是未解释的比例, 是 0.364。
- F 是均方之比 MSR/MSE。直接用 SSR 除以 SSE 忽略了自由度。上面的例题中,这样算得 ,而不是 。
- SEE 要先用 SSE 除以自由度 ,再开平方。除以 会低估 SEE。上面的例题中,,而不是 2。
- 斜率为负时 为负,尽管 为正。斜率的标准误(standard error)是另一个统计量,不是相关系数(correlation coefficient)。
答题技巧
- 只有一个自变量时,(检验 对 ),所以在同一显著性水平(significance level)下,F 检验与斜率的双尾 t 检验结论相同,只算一个即可。
- 题目只给 和 SSR 时,SST SSR,SSE SST SSR,由此直接得到 MSE 和 SEE。
- 一元回归中 ,符号取斜率的符号。
本节要点
- 一元线性回归(simple linear regression)假设:关系是线性的,残差同方差,残差之间互不相关,残差服从正态分布。
- 残差方差随 X 或随时间变大或变小是异方差性(heteroskedasticity);残差之间相关(例如反复出现的季节性规律)说明存在自相关。
- ANOVA 把总变动拆成已解释和未解释两部分,。
- 一元回归中 ,,,等于 。
- ,自由度为 1 和 ,是单尾检验;只有一个自变量(independent variable)时,它检验 ,与斜率的 t 检验是同一个假设。
- 用 Y 对指示变量回归,斜率等于条件成立与不成立两类时期 Y 的均值之差,截距(intercept)等于指示变量为 0 时的均值。
随堂小测
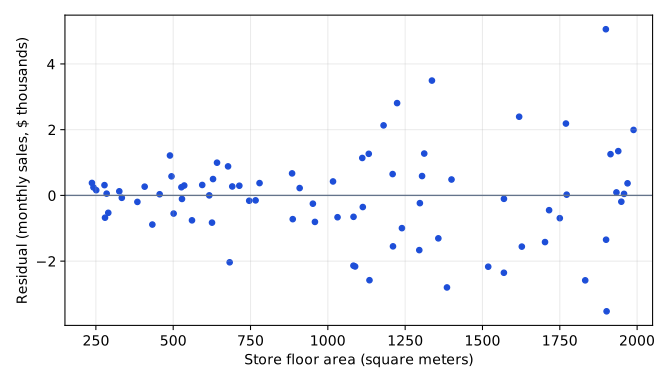
An analyst regresses the monthly sales of 80 stores on each store's floor area. The figure below plots the regression residuals against floor area. The pattern most likely indicates that the regression's residual term:
查看答案和解析
正确答案: A
随着营业面积增大,残差呈扇形散开:残差的离散程度(方差)随自变量增大而变大。各观测值的残差方差不恒定就是异方差性(heteroskedasticity),违背了同方差性(homoskedasticity)假设。
其他选项为什么错
- B. 图中残差以零为中心,只是离散程度在变化,看不出残差分布形状有什么特别的非正态迹象。正态性要看残差分布的形状;离散程度怎样随 X 变化是另一个问题。
- C. 不独立(自相关)表现为残差之间相关,例如随时间反复出现的季节性规律。离散程度随 X 变大是方差问题。
本题要点 残差离散程度随 X 变大 = 异方差性(残差方差不恒定)。
模块 10.3
回归的预测值与函数形式(Predicted Values and Functional Forms of Regression)
LOS 10.c — 预测值、预测区间与函数形式
预测值(predicted value)
因变量(dependent variable)的预测值(predicted value),是把自变量(independent variable)的预测值 代入估计方程得到的:
*例:*,:。别漏掉截距(intercept),每一项的符号都要保留。
预测值的置信区间(预测区间(prediction interval))
核心概念
其中 是预测标准误(standard error of the forecast)。一级考试通常会直接给出;如果没给:
核心概念
以下情况下预测更精确( 更小):估计标准误(standard error of estimate, SEE)更小,样本(sample)更大, 更接近 ,自变量的方差(variance)更大。
*例(续):*,,所以 ,5% 双尾临界值(critical value)为 2.060。95% 区间为 ,即 1.71 到 7.89。
*没有给出 时的计算(另一个回归):*SEE = 2.0,,,,:
预测标准误总是大于 SEE:预测既带有残差(residual)的不确定性,也带有估计系数的不确定性。
| 区间 | 中心 | 宽度取决于 |
|---|---|---|
| 系数的置信区间(confidence interval, CI) | (或 ) | 该系数的标准误(standard error) |
| Y 的预测区间 | (在 处) | 预测标准误 |
函数形式(functional form)
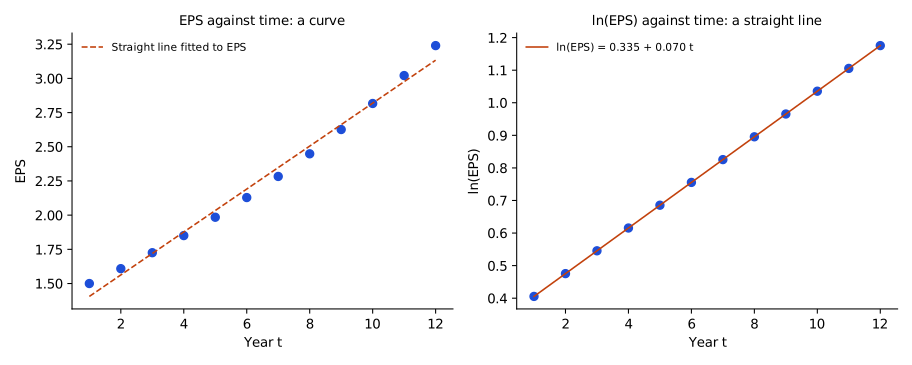
如果 X 与 Y 之间不是线性关系,可以对因变量、自变量或两者取自然对数,把关系变成线性。例如,每股收益(earnings per share, EPS)随时间以大致不变的百分比增长时,画出来是一条向上弯的曲线。
核心概念
| 模型 | 方程 | 斜率的含义 | 典型用途 |
|---|---|---|---|
| 对数-线性模型(log-lin model) | X 绝对变动时 Y 的相对(%)变动 | 随时间以不变增长率增长 | |
| 线性-对数模型(lin-log model) | X 相对(%)变动时 Y 的绝对变动 | Y 对 X 的比例变动做出反应 | |
| 双对数模型(log-log model) | X 相对变动时 Y 的相对变动(即弹性(elasticity)) | 两个变量都按比例衡量 |
*例:*用公司年度 EPS 对时间指数(1, 2, 3, …)做对数-线性回归,斜率为 0.07 表示 EPS 每年大约增长 7%(精确值为 ),而不是 EPS 每年增加 0.07 个货币单位。
选择函数形式,要看变量的性质,并比较拟合优度指标和残差图。
- 考试惯例: 较高、F 统计量(F-statistic)较高、SEE 较低的函数形式拟合更好。
- 现行做法:只有因变量相同时, 和 SEE 才能直接比较; 的模型和 的模型衡量拟合的尺度不同。
常见考试陷阱
- 一元回归的预测区间用 (估计了两个参数(parameter)),不是 。上例中如果用 26 个自由度,临界值为 2.056,区间为 1.72 到 7.88,而不是 1.71 到 7.89。
- 预测区间用的是预测标准误 。斜率的标准误用于斜率系数(slope coefficient)的区间。
- "log"放在取对数的那个变量的位置上:log-lin 表示 Y 取对数、X 保持线性。
答题技巧
- 预测标准误总是大于 SEE,所以比 SEE 还窄的预测区间可以直接排除。
本节要点
- 预测值(predicted value)为 ,要用上截距并保留每一项的符号。
- Y 的预测区间为 ,自由度为 ,其中 是预测标准误。
- SEE 越小、样本(sample)越大、 越接近 、自变量方差越大,预测越精确。
- 对数-线性模型( 对 X)的斜率是 X 绝对变动时 Y 的相对变动;线性-对数模型是 X 相对变动时 Y 的绝对变动;双对数模型的斜率是弹性。
- 考试惯例: 较高、F 统计量较高、SEE 较低的函数形式拟合更好;现行做法:只有因变量(dependent variable)相同时, 和 SEE 才能直接比较。
随堂小测
An analyst regresses a fertilizer producer's monthly stock returns on monthly changes in a crop price index, using 32 observations. The estimated coefficients are in the table below. She expects next month's change in the index to be −0.015 and computes a standard error of the forecast of 0.028. Critical t-values with 30 degrees of freedom are 1.310 with 10% in one tail and 1.697 with 5% in one tail. The 90% prediction interval for next month's return is closest to:
| Coefficient | Standard error | |
|---|---|---|
| Intercept | 0.0040 | 0.0035 |
| Crop price change | 0.6500 | 0.2100 |
查看答案和解析
正确答案: A
预测区间等于预测值(predicted value)加减临界 t 值乘以预测标准误。双侧 90% 区间每个尾部各留 5%,所以自由度为 n − 2 = 30 时,临界值为 1.697。
- 预测收益率:
- 半宽:
- 区间:,即 到
计算器:0.65 [×] 0.015 [=] 得 0.00975;1.697 [×] 0.028 [=] 得 0.047516。
其他选项为什么错
- B. 这个区间用的是 1.310,即单尾 10% 的临界值。双侧 90% 区间把 10% 分到两个尾部,每个尾部 5%。
- C. 这个区间以 为中心,漏掉了指数预测变动的负号。
本题要点 预测区间 ,自由度为 n − 2,每个尾部 α/2。计算 时保留预测 X 的符号。
模块 10.4
用一元线性回归估计 CAPM 参数(Estimating CAPM Values With Simple Linear Regression)
LOS 10.d — 用一元线性回归(simple linear regression)估计 CAPM
作为单因子回归的 CAPM
资本资产定价模型(capital asset pricing model, CAPM)为
CAPM 唯一的解释变量是市场风险溢价(market risk premium, MRP),所以它是单因子风险模型(one-factor risk model),可以用一元线性回归(simple linear regression)估计,用过去的观测值代替预期值。等式两边同时减去 ,得到可估计的形式:
核心概念
核心概念
| 回归中的要素 | 在 CAPM 中的含义 |
|---|---|
| 因变量(dependent variable) | 资产的超额收益率(excess return) |
| 自变量(independent variable) | 市场风险溢价 |
| 斜率 | 资产**贝塔系数(beta)**的估计值 |
| 截距 | 市场敞口解释不了的收益率(CAPM 完全成立时为零) |
步骤
- 收集数据:资产的收益率;用证券市场指数(security market index)代表市场收益率(market return);用短期政府债务(short-term government debt)的收益率代表无风险利率(risk-free rate)。通常至少需要 30 个观测值(例如 1–3 年的周度数据或 3–5 年的月度数据)。
- 计算每期资产的超额收益率(excess return)和市场风险溢价。
- 用最小二乘法将超额收益率对市场风险溢价回归。
- 用 和预期的市场风险溢价估计预期收益率(expected return):。
贝塔的检验与解释
*例:*斜率为 1.25,标准误(standard error)为 0.10(大样本(sample),所以用 z 值)。
- 贝塔大于 1:股票的超额收益率会放大市场的波动;小于 1:会减弱市场的波动。
- 检验 :,拒绝;贝塔显著不等于零。
- 95% 置信区间(confidence interval, CI): 到 。
- 检验 (股票是否与市场同比例变动?):,拒绝;贝塔显著不等于 1,且估计值在它上方。这与上面的区间一致:区间不包含 1。
- 单侧问题,例如贝塔是否大于 1,用 对 ,统计量同样是 ,临界值(critical value)用单尾的。
- 、预期市场风险溢价为 5% 时:。
*输入变化时:*。设 , 上升 0.4%,同时市场风险溢价下降 0.4%,预期收益率变动 ;贝塔大于 1 时,同样的变化会使预期收益率下降。
看懂典型的回归输出
| 系数 | 标准误 | t 统计量 | |
|---|---|---|---|
| 截距 | 0.05 | 0.08 | 0.63 |
| 市场风险溢价(斜率) | 1.25 | 0.10 | 12.50 |
斜率那一行给出贝塔及其检验;这里截距(intercept)那一行不显著(t = 0.63),与 CAPM 截距为零的预测一致。这类回归的 说明资产超额收益率的变动中有多少是系统性的(由市场驱动); 是非系统性的部分。
样本的选择
样本期越长,观测值越多,估计越精确,但可能包含公司业务构成、杠杆(leverage)以及贝塔都与现在不同的时期。频率更高的数据(日度或周度)能很快增加观测值,但对交易清淡的资产噪声较大。怎样选取决于用途:短线投机者偏好近期的高频数据(high-frequency data);买入并持有的投资者偏好至少覆盖一个完整经济周期(business cycle)的月度或季度数据。
例题详解:估计并检验 CAPM 贝塔
某股票超额收益率与市场风险溢价的六十个月度观测值,给出协方差(covariance)0.00168,市场风险溢价的方差(variance)0.00140。回归报告的斜率标准误为 0.16;60 个观测值属于大样本,所以 5% 双尾临界值为 1.96。要求:估计贝塔;在 5% 水平下检验贝塔是否不等于 1;构造相应的贝塔置信区间;无风险利率为 2.8%、预期市场风险溢价为 5.5% 时,估计这只股票的预期收益率。
第 1 步。贝塔就是斜率系数(slope coefficient):。
第 2 步。检验 对 :。1.25 小于 1.96,不拒绝 ,贝塔与 1 没有显著差异。
第 3 步。95% 置信区间为 ,即 0.886 到 1.514。区间包含 1,与第 2 步一致。
第 4 步。预期收益率:。
结果:估计的贝塔为 1.20,在 5% 水平下与 1 没有显著差异,CAPM 预期收益率为 9.4%。
常见考试陷阱
- 因变量(dependent variable)是资产的超额收益率(excess return),自变量(independent variable)是市场风险溢价(market risk premium, MRP)。用原始收益率对原始收益率回归,不是 CAPM 的设定。
- 贝塔是斜率系数。截距和贝塔无关,截距为负并不意味着贝塔为负。
- 贝塔的置信区间(confidence interval, CI):斜率 临界值(critical value) 斜率的标准误(standard error)。截距的标准误用不上。用上面的输出,如果错用截距的 0.08,会得到 1.093 到 1.407,而不是 1.054 到 1.446。
答题技巧
- 贝塔的 95% 双尾置信区间不包含 1,说明在 5% 水平下拒绝 ;包含 1,则不拒绝。知道其中一个结果就知道另一个。
本节要点
- 估计 CAPM 时,用资产的超额收益率(excess return) 对市场风险溢价(market risk premium, MRP) 回归;斜率是资产的贝塔,CAPM 完全成立时截距为零。
- 证券市场指数(security market index)代表市场收益率,短期政府债务的收益率代表无风险利率(risk-free rate),通常至少需要 30 个观测值。
- 检验贝塔用 ,置信区间(confidence interval, CI)为斜率 临界值(critical value) 斜率的标准误(standard error)。
- 预期收益率为 ;输入变化时,。
- CAPM 回归的 是资产超额收益率(excess return)变动中系统性的部分, 是非系统性的部分。
- 样本期越长,估计越精确,但可能包含贝塔不同的时期;频率更高的数据对交易清淡的资产噪声较大。
随堂小测
To estimate a stock's beta, an analyst regresses the stock's excess returns on the market risk premium and obtains an intercept of −0.15 and a slope of 0.72. Based on this model, the stock's beta is:
查看答案和解析
正确答案: B
在回归 中,斜率系数是资产贝塔的估计值。斜率为 0.72,所以贝塔介于 0 和 1 之间:这只股票的超额收益率(excess return)随市场风险溢价(market risk premium, MRP)变动的幅度往往小于一比一。
其他选项为什么错
- A. 负数是截距,不是贝塔。贝塔是斜率 0.72。
- C. 贝塔大于 1 要求斜率大于 1;估计的斜率是 0.72。
本题要点 贝塔 = 超额收益率回归的斜率;截距与贝塔无关。
本章题库共 29 道题。 去题库全部练习。
本章要点
- 因变量(Y):被解释变量、内生变量、被预测变量。自变量(X):解释变量、外生变量、预测变量。哪个是哪个,由研究问题决定。
- 残差离散程度随 X 变大 = 异方差性(残差方差不恒定)。
- 预测区间 ,自由度为 n − 2,每个尾部 α/2。计算 时保留预测 X 的符号。
- 贝塔 = 超额收益率回归的斜率;截距与贝塔无关。