数量方法 · 第 9 章
金融资产价格与收益率的模拟(Simulation of Financial Asset Prices and Returns)
CFA 一级 · 数量方法 · 第 9 章 · 约 45 分钟
本章学习目标
- LOS 9.a 描述历史模拟及其假设、优点和缺点,以及它在投资中的应用,例如 VaR 和债券组合。
- LOS 9.b 描述自助重抽样(有放回抽样)及其优点、缺点和投资应用。
- LOS 9.c 描述蒙特卡洛模拟,包括用 Cholesky 分解(Cholesky decomposition)做多变量模拟,以及它的优点、缺点和投资应用。
模块 9.1
历史模拟(Historical Simulation)
本章介绍模拟资产价格和收益率的三种方法:历史模拟(historical simulation),把过去实际发生的变动套用到当前头寸上;自助重抽样(bootstrap resampling),从观测样本(sample)中有放回地抽取;蒙特卡洛模拟(Monte Carlo simulation),从分析师设定的分布中抽取。每种方法都讲它的假设、投资应用(如风险价值(value at risk, VaR)和期权(option)估值)以及主要优缺点。
LOS 9.a — 历史模拟
模拟做什么
核心概念
**模拟(simulation)**是一种预测建模方法。它让一个复杂系统跑过大量情景,估计可能结果的分布范围,例如组合的收益率分布、组合风险、未来现金流和流动性(liquidity)。所有模拟都按同样的四步走:
- 设定参数:明确目标,选定输出变量,确定从输入到输出的计算关系。
- 生成情景:为每次试验生成输入值(可以很简单,也可以从复杂分布中抽取)。
- 评估情景:把每个情景送入计算引擎,得到结果路径。
- 汇总和解读结果:把结果汇总(例如汇总成一个分布),得出结论。
历史模拟(本模块)、自助重抽样(模块 9.2)和蒙特卡洛模拟(模块 9.3)的主要区别在第 2 步,也就是情景从哪里来。
历史模拟
历史模拟把价格、收益率或风险因子过去的实际变动套用到当前的组合头寸上。它假设过去的数据能代表未来:过去的表现可以可靠地指引未来的结果和风险,历史记录代替了结果的总体(population)。设定参数时,选定的日期和风险因子可能要做一些简化假设,让所有收益率覆盖相同的时间段。权益(equity)类输入通常用对数(连续复利)价格收益率,用百分比收益率也可以;债券则用模拟出的收益率作为未来现金流的折现率(discount rate)。
核心概念
| 优点 | 缺点 |
|---|---|
| 容易解释:可以围绕真实的历史事件讲清楚 | 假设过去会重演;遇到**结构性变化(regime changes)**或前所未有的事件时效果差 |
| 非参数(nonparametric):不必把数据硬套进正态分布(normal distribution)之类的分布;能处理超额峰度(excess kurtosis)、偏度(skewness)和厚尾(fat tails),比参数模型更能捕捉极端事件和漂移 | 只能产生回溯期内实际发生过的结果 |
| 能捕捉波动率聚集(volatility clustering)(平静期和动荡期往往会持续) | 结果取决于数据的质量和完整性 |
缺失数据和代理变量
历史记录出现缺口的原因有:交易清淡的品种,全球市场不同步(假日、系统故障、停牌),以及部分时期内证券还不存在(例如刚完成首次公开发行(initial public offering, IPO)的股票)。解决办法是用代理变量(proxy):用一个替代品种,或几个有数据的品种的加权组合,来代替缺失的观测值。
应用:风险价值(VaR)
核心概念
VaR 是在指定期间内,最差 5%(或 1%)的结果中预期的最小损失。也可以说,它是对应置信水平(95% 或 99%)下的最大潜在损失;尾部仍会出现更大的损失。对只做多的组合用历史模拟计算 VaR:
- 设定参数:算出回溯期内每项资产的日收益率(通常用对数收益率)。
- 生成情景:把每一天的收益率套用到今天的头寸上,每个历史交易日得到一个损益(profit or loss, P&L)数字。
- 评估情景:构建 P&L 分布(例如画直方图)。
- 汇总和解读:把 P&L 从最差到最好排序;95% VaR 就是分布的第五百分位数(percentile)。如果这个百分位数落在两个观测值之间,取其中任一个或二者的加权平均都可以。
*例(历史 VaR 与参数 VaR 对比):*一个 $4 million 的股票组合,用过去 500 个交易日的收益率情景逐一重新估值。500 个结果的 5% 是 25 个,所以第五百分位数落在第 25 差的 P&L(−$118,000)和第 26 差的 P&L(−$114,000)之间。1 天 95% 历史 VaR 约为 $116,000(两个相邻值的平均;取其中任一个也可以)。如果用参数法,假设收益率服从正态分布,日均值为零,日标准差(standard deviation)为 1.5%,得到 。历史 VaR 更大,因为实际收益率分布的左尾比正态分布更厚。
VaR 只看损失尾部,所以少数几次大额收益对它几乎没有影响。算日 VaR 时,分析师通常假设平均收益率为零:日漂移在统计上很难与零区分开(即无方向性变动的原假设(null hypothesis, H0)),而且日波动远远大于任何趋势。
应用:债券
债券自己的历史价格会误导分析,因为它对利率的敏感度(久期(duration))随着临近到期日(maturity)不断缩短:五年前买入的 10 年期零息债券(zero-coupon bond),现在的表现像一只 5 年期债券。所以债券的历史模拟用收益率的历史变动(例如相同剩余期限的基准(benchmark)收益率),把它套用到今天的现金流上。要模拟一只还有三年到期的债券,就用当时剩余期限为三年的债券上观测到的收益率变动。
常见考试陷阱
- 历史模拟假设过去的数据能代表未来。用统计模型拟合总体是蒙特卡洛模拟(Monte Carlo simulation),有放回地重抽样是自助法。
- 历史 95% VaR 是模拟 P&L 分布的第五百分位数(500 个结果中大约第 25 差的那个),不是唯一最差的那个结果。
- 代理变量用来填补缺失数据;它不是风险因子,也不是假设情景。
答题技巧
- 有 个历史情景时,95% VaR 落在第 差的 P&L 和排在它后面的下一个 P&L 之间,只需找出这两个结果(取其中任一个或二者的加权平均都可以)。
本节要点
- 所有模拟都要设定参数、生成情景、评估情景、汇总结果;历史模拟、自助法和蒙特卡洛模拟(Monte Carlo simulation)的主要区别在于情景从哪里来。
- 历史模拟把价格、收益率或风险因子过去的实际变动套用到当前组合头寸上,假设过去的数据能代表未来。
- 历史模拟是非参数方法,能捕捉偏度(skewness)、超额峰度(excess kurtosis)、厚尾(fat tails)和波动率聚集;但它只能产生回溯期内的结果,遇到结构性变化或前所未有的事件时效果差。
- 缺失的历史数据用代理变量填补,即一个替代品种,或几个有数据的品种的加权组合。
- VaR 是指定期间内最差 5%(或 1%)结果中的最小损失;95% 历史 VaR 是模拟 P&L 分布的第五百分位数,日 VaR 通常假设平均收益率为零。
- 债券的久期(duration)随着临近到期日(maturity)不断缩短,所以债券的历史模拟不用债券自己的历史价格,而是把相同剩余期限的历史收益率变动套用到今天的现金流上。
随堂小测
Which of the following is most likely an advantage of historical simulation compared with a parametric approach that assumes normally distributed returns?
查看答案和解析
正确答案: B
历史模拟是非参数方法:它用过去的实际变动,所以情景自然带有数据中的厚尾(fat tails)、偏度(skewness)和波动率聚集。正态分布模型往往低估极端结果。
其他选项为什么错
- A. 依赖过去正是历史模拟的主要缺点;出现结构性变化后,过去的数据可能不再代表未来。
- C. 历史模拟只能重现回溯期内实际发生过的结果;模拟从未出现过的情况是蒙特卡洛模拟(Monte Carlo simulation)的优点。
本题要点 历史模拟是非参数方法,能捕捉厚尾和波动率聚集,也容易解释;它的局限是只能重放实际发生过的事。
模块 9.2
自助重抽样(Bootstrap Resampling)
LOS 9.b — 自助重抽样
自助法怎么做
核心概念
自助重抽样(bootstrap resampling)(又称自助法(bootstrapping))是一种非参数(nonparametric)模拟方法。它把观测到的历史样本(sample)当作总体(population)的代理(proxy),从中有放回地(with replacement)随机抽取观测值,生成大量新数据集:每个观测值抽出、使用后放回,下次还可能被抽到。这样抽取一个随机值叫作抽取(pulling)。
- 数据集有 个观测值时,每次抽取中每个观测值被选中的概率都是 。
- 在一个情景内,同一个观测值被抽中的次数最多等于该情景的抽取次数。
- 在不同情景之间,同一个观测值可以出现在很多样本中(也可能一个都不出现)。
*例:*要用 60 个历史月收益率模拟一条 6 个月的路径,就在 1 到 60 之间抽六个随机整数,查出对应的收益率。任何一个月份在每次抽取中被抽中的机会都是 1/60,理论上它最多可以在同一条路径中出现六次(虽然可能性很小)。重复几千次。
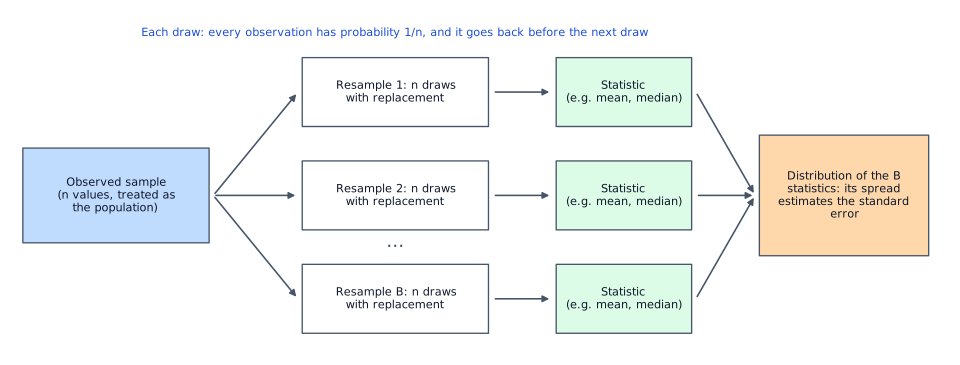
自助法与历史模拟(historical simulation)的区别
两种方法对待数据的方式不同。历史模拟把过去的数据集当作总体直接重放,所以每个情景都是实际发生过的一串事件。自助法把观测样本当作总体的代理,通过有放回的重抽样,用过去的观测值拼出新的组合。模块 9.3 把三种模拟方法放在一起比较。
自助法不需要理论模型。每次重抽样得到所关心统计量(比如均值)的一个值,几千次重抽样就近似描出这个统计量的抽样分布(sampling distribution),即使原始数据集很小也可以。看这个分布的离散程度,就能判断估计值是否稳定。反复重抽样比历史模拟多花一些计算量。自助法保留了数据的经验分布,只是把它重新打乱,所以能降低对某一段特定历史序列过拟合(overfitting)的风险。总体分布未知、但可以从样本推断时,适合用自助法解决金融问题。
应用
- 欧式看涨期权(European-style call option)到期时的价值。欧式看涨期权只能在到期日(maturity)行权,只有标的资产(underlying)价格最终高于行权价(exercise price)时才有价值,所以目标是期权(option)到期时的价值。对历史收益率重抽样,构建投资期内的大量价格路径,算出每条路径终点的期权收益,再研究得到的分布及其均值。这样就避开了理论期权定价模型中波动率不变和正态分布的假设。期权有杠杆(leverage),下跌损失有限,所以期权价值的分布可能比股价分布更偏斜。得到的是历史(真实世界)收益率下到期收益的分布。它本身不是期权当前的无套利(no-arbitrage)价格:把真实世界下的平均收益按无风险利率(risk-free rate)折现,得不到这个价格(模块 9.3 列出了蒙特卡洛模拟(Monte Carlo simulation)定价的条件)。
- 估计目标日期基金(target date fund)的波动率(这类基金随着退休日期临近,逐步转向风险较低的资产):对月收益率做自助重抽样,算出每条模拟序列的标准差(standard deviation),比较各基金的波动率区间,判断哪只基金更激进。
优点和缺点
核心概念
| 优点 | 缺点 |
|---|---|
| 假设最少:不必设定正态分布之类的分布 | 对样本质量敏感:原始样本中的任何偏差都会带进每个重抽样样本 |
| 实现起来简单 | 大数据集上做几千次重抽样,计算量大 |
| 统计上稳健:即使样本很小,也能可靠地估计统计量的变异程度 | 没有解析层面的解释:只给估计值,不给理论解释 |
| 标准误和置信区间可靠,受异常值(outliers)影响小 | 外推能力有限:不能生成观测数据范围之外的结果(对极端尾部事件效果差) |
| 适用于多种统计量(均值、中位数(median)、相关性(correlation)) | 不适合自相关的时间序列(time series):随机重抽样会打断数据在时间顺序上的依赖关系 |
| 用手头的样本就能做,不需要大型外部数据集 |
数据表现出时变波动率、偏度(skewness)或厚尾(fat tails),难以用参数方法建模,而且预期历史规律会延续时,自助法很有用。它是对解析方法的补充,解析方法能更详细地解释背后的关系。
常见考试陷阱
- 自助法不对分布做任何假设;需要设定分布的是蒙特卡洛模拟。
本节要点
- 自助法是非参数方法,把手头的样本当作总体(population)的代理,从中有放回地随机抽取,构建新数据集,所以 个观测值中每一个在每次抽取中被选中的概率都是 。
- 在自助法中,同一个观测值可以在一个情景内被抽中多次,也可以出现在很多样本(sample)中,或一个都不出现。
- 历史模拟把过去的数据集当作总体(population)重放;自助法用过去的观测值拼出新的组合,降低了对某一段历史序列过拟合的风险。
- 自助法可以给出历史收益率下欧式看涨期权到期收益的分布,但这本身不是期权当前的无套利价格;它也可以估计目标日期基金的波动率。
- 自助法需要的假设最少,样本(sample)小也能用;但它会把原始样本中的偏差带进每个重抽样样本,不能生成观测范围之外的结果,也不适合自相关的时间序列(time series)。
随堂小测
An analyst builds each bootstrap scenario for an eight-quarter horizon by drawing from a dataset of 40 historical quarterly returns. Within a single scenario, any one historical observation can be drawn:
查看答案和解析
正确答案: A
自助法是有放回抽样:每次抽取后,观测值放回数据集。八个季度的情景需要抽八次,所以理论上同一个观测值每次都可能被抽中,不过每次只有 1/40 的机会,这种情况极不可能发生。
每个情景由 8 次抽取组成,每次在 1 到 40 之间抽一个随机整数,对应一个历史季度收益率。某个观测值在任何一次抽取中被选中的概率是 ,它在一个情景中最多出现的次数等于抽取次数,即 8 次。
其他选项为什么错
- B. “Only once”描述的是无放回抽样。自助重抽样每次都把观测值放回,所以可以重复。
- C. 40 是数据集的大小;八个季度的情景只包含八次抽取。
本题要点 有放回抽样:可以重复,上限是该情景的抽取次数。
模块 9.3
蒙特卡洛模拟(Monte Carlo Simulation)
LOS 9.c — 蒙特卡洛模拟
方法
蒙特卡洛模拟(Monte Carlo simulation)生成情景的方式,是从分析师设定的概率分布(probability distribution)中随机抽样(可以是正态分布(normal distribution)、对数正态分布(lognormal distribution),或任何形状、任何参数的分布),而不是从原始历史观测值中抽取。跑几千次试验,得到价格或收益率的模拟频率分布(simulated frequency distribution),再从中估计风险和业绩指标。试验次数在可行范围内越多越好:次数越多,估计越精确,而试验次数基本上只受计算能力和时间的限制。输入假设由分析师控制,所以可以检验输出对每个假设的敏感度(“假如……会怎样”("what if")分析)。
应用
- 组合业绩:在给定置信水平下,估计未来一段期间的预期收益率(expected return)和标准差(standard deviation)。
- 为没有解析(闭式)定价公式的证券估值,例如路径依赖期权(path-dependent option)(如亚式期权(Asian-style options),收益取决于平均价格)、抵押贷款支持证券(mortgage-backed securities, MBS)(借款人的提前还款权相当于一个嵌入式看涨期权)和可转换债券(convertible bonds)。
- 欧式看涨期权(European call options)。
- 考试惯例:欧式看涨期权的蒙特卡洛估值应与 Black-Scholes-Merton 模型的估值一致,试验次数越多越接近。
- 现行做法:只有模拟的价格动态符合 Black-Scholes-Merton 的假设时,这一点才成立:价格服从对数正态分布,波动率不变,而且定价时预期收益率等于无风险利率(risk-free rate)减去股息收益率(dividend yield)(风险中性定价(risk-neutral valuation))。这时按无风险利率折现的平均收益,会随试验次数增加收敛到 Black-Scholes-Merton 估值。只假设对数正态分布还不够:用真实世界的预期收益率模拟,再按无风险利率折现,得不到这个值。
期权估值的步骤:(1)设定期限、无风险利率、价格分布(例如对数正态分布)、波动率和预期收益率;(2)抽随机数,生成价格路径;(3)跑几千次试验,算出每条路径上的期权(option)收益;(4)把收益取平均,按无风险利率折现。
多变量模拟与 Cholesky 分解
几个变量一起变动时(一个组合,或一份基于多项资产的期权),模拟的输入必须有正确的相关性(correlation)。在常用的对数正态价格模型下,假设各资产的对数收益率服从联合正态分布,输入是每项资产的波动率和收益率之间的相关系数。Cholesky 分解(Cholesky decomposition)把协方差矩阵(或相关系数矩阵)分解,把相互独立的标准正态抽样值转换成相关的正态变量,再用这些变量生成模拟路径。两个变量、独立抽样值为 和 (均值 0,标准差 1)时:
核心概念
*例:*设 ,,,抽样值 、,则 ;。
优点和缺点
核心概念
| 优点 | 缺点 |
|---|---|
| 适用范围广:资产、风险因子、组合;非线性关系、时变波动率、厚尾(fat tails) | 复杂:需要建模专长,搭建耗时 |
| 能灵活处理非正态分布(偏度(skewness)、超额峰度(excess kurtosis)) | 依赖模型:结果的好坏取决于假设的分布和参数 |
| 试验次数足够时精确 | 计算量大:实时使用时又慢又贵 |
| 能处理多项资产之间的相关性 | 数据要求高:估计波动率、相关系数等参数需要大量数据 |
| 前瞻性:能模拟历史上从未出现过的假设情况或极端情况 | 给出的是统计估计值,不是精确答案,也给不出解析方法那样的洞察(因果关系) |
蒙特卡洛模拟通常和解析方法配合使用。没有解析方法可用时,它本身就可以作为估值工具,再通过改变假设、重新运行来检验结果是否稳健。
三种方法的比较
核心概念
| 特征 | 历史模拟(historical simulation) | 自助法(bootstrapping) | 蒙特卡洛模拟 |
|---|---|---|---|
| 数据来源 | 历史数据集 | 观测样本(sample) | 假设(建模)的分布 |
| 抽样方式 | 直接取自历史 | 有放回重抽样 | 从设定的分布中随机抽取 |
| 假设 | 过去的数据代表未来 | 样本代表总体(population) | 生成结果的过程可以用统计方法建模 |
| 典型用途 | 风险管理(risk management)、压力测试(stress testing) | 置信区间、标准误 | 复杂系统、长期结果 |
| 灵活性 | 局限于历史规律 | 受样本大小限制 | 非常灵活,可做假设情景 |
| 捕捉的不确定性 | 只有历史上观测到的 | 重抽样带来的变异 | 来自建模输入的假设不确定性 |
| 计算量 | 低到中等 | 中等 | 高 |
常见考试陷阱
- Cholesky 分解(Cholesky decomposition)根据假设的相关系数生成相关的路径;它不估计相关系数或协方差。
答题技巧
- 看情景从哪里来就能判断方法:用过去的实际变动是历史模拟(historical simulation),从观测样本(sample)中有放回地重抽样是自助法,从假设的分布中随机抽取是蒙特卡洛模拟。
本节要点
- 蒙特卡洛模拟从分析师设定的概率分布中抽取情景,跑几千次试验构建模拟频率分布;试验次数越多,估计越精确。
- 蒙特卡洛模拟用来估计组合业绩,也用来为没有闭式定价公式的证券估值,例如亚式期权、抵押贷款支持证券(mortgage-backed securities, MBS)和可转换债券(convertible bonds)。
- 考试惯例:欧式看涨期权的蒙特卡洛估值应与 Black-Scholes-Merton 估值一致,试验次数越多越接近;现行做法:只有模拟价格服从对数正态分布(lognormal distribution)、波动率不变、预期收益率为风险中性收益率,并且平均收益按无风险利率折现时,这一点才成立。
- Cholesky 分解(Cholesky decomposition)用假设的相关系数,把相互独立的标准正态抽样值转换成相关的正态变量;它不估计相关系数或协方差。
- 蒙特卡洛模拟灵活、有前瞻性,能处理非正态分布和相关性;但它复杂、依赖模型、计算量大、需要大量数据,给出的是统计估计值,没有解析方法那样的因果洞察。
- 历史模拟(historical simulation)假设过去的数据代表未来,自助法假设样本代表总体(population),蒙特卡洛模拟假设生成结果的过程可以用统计方法建模。
随堂小测
Compared with historical simulation and bootstrap resampling, an advantage of Monte Carlo simulation is that it:
查看答案和解析
正确答案: C
蒙特卡洛模拟的情景由分析师选定的分布生成,所以它可以模拟历史记录中从未出现过的假设情况或极端情况。历史模拟(historical simulation)和自助法只能重复使用实际发生过的事。
其他选项为什么错
- A. 蒙特卡洛模拟通常对数据要求很高,因为要估计波动率、相关系数和其他参数。
- B. 与重放或重抽样实际历史的方法相比,蒙特卡洛模型更复杂,也更难向别人解释。
本题要点 蒙特卡洛模拟有前瞻性:能为历史上没有先例的情景建模。
本章题库共 16 道题。 去题库全部练习。
本章要点
- 历史模拟是非参数方法,能捕捉厚尾和波动率聚集,也容易解释;它的局限是只能重放实际发生过的事。
- 有放回抽样:可以重复,上限是该情景的抽取次数。
- 蒙特卡洛模拟有前瞻性:能为历史上没有先例的情景建模。