数量方法 · 第 6 章
金融资产价格与收益率的统计分布(Statistical Distributions for Financial Asset Prices and Returns)
CFA 一级 · 数量方法 · 第 6 章 · 约 1 小时 3 分钟
本章学习目标
- LOS 6.a 计算并解读随机变量的无条件均值、方差、标准差和协方差,包括根据情景表和联合概率表计算。
- LOS 6.b 描述离散均匀分布、二项分布、泊松分布、连续均匀分布、正态分布、对数正态分布和逻辑斯谛分布的形状、主要矩及其在金融中的典型用途。
- LOS 6.c 计算并解读条件期望、条件方差和条件协方差,包括根据联合概率表和概率树计算。
- LOS 6.d 出现新信息时,用贝叶斯公式(Bayes' formula)把先验概率更新为后验概率。
模块 6.1
概率分布与期望值(Probability Distributions and Expected Values)
本章用概率分布(probability distribution)描述随机变量(random variable),并用期望值(expected value)、方差(variance)和协方差(covariance)加以概括。随后把常见的离散分布和连续分布与它们所刻画的金融变量分别对应,并说明出现新信息时,如何用条件期望和贝叶斯公式(Bayes' formula)更新预测。
LOS 6.a — 随机变量的无条件均值、方差和协方差
随机变量:离散与连续
随机变量是一个在观察到结果之前取值未知的量,英文也叫 stochastic variable。
| 特征 | 离散随机变量(discrete random variable) | 连续随机变量(continuous random variable) |
|---|---|---|
| 可能取值 | 可数的集合(例如一个 50 只债券的组合里,今年被降级的发行人数量) | 某个区间内的无穷多个值(例如明天金价的百分比变动) |
| 概率函数 | 概率质量函数(probability mass function, PMF): 可以大于零 | 概率密度函数(probability density function, PDF):每一个单点上 |
| 概率赋给 | 单个结果 | 区间,例如 |
| 结果能否为负? | 能,只要可数集合里包含负数 | 能;也可以把取值范围限定为正值 |
概率分布列出随机变量所有可能结果的概率,这些概率之和为 1。概率函数(probability function) 给出 X 等于某个特定值的概率。对离散变量来说,不可能出现的值 ,可能出现的值 。
变量是否离散,与结果是否等可能(即均匀分布(uniform distribution)的情形)或是否为正无关。以美分报价的价格严格说来是离散的。但可能的取值太多,分析师通常把它当作连续变量,讨论价格变动落在某个区间的概率。
什么样的函数是有效的概率函数
函数 必须同时满足以下两个条件,才是概率函数:
核心概念
- ,对每个可能结果 都成立;
- 所有可能结果上 。
0.50、0.40、0.20、−0.10 这组数之和为 1,但不满足条件 1。五个 0.25 满足条件 1,但加总为 1.25,不满足条件 2。
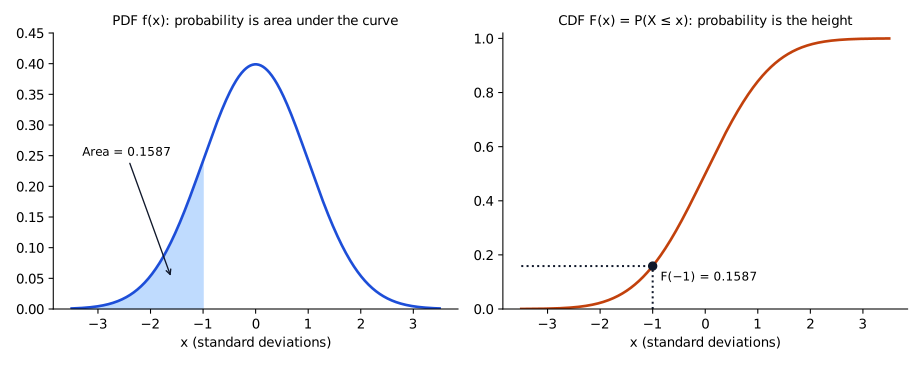
连续变量在单个点上没有概率,所以区间包不包含端点,概率都一样:。PDF 在某一点的高度是密度。概率是 PDF 在某个区间上围成的面积。
累积分布函数(CDF)
累积分布函数(cumulative distribution function, CDF),也叫分布函数(distribution function),给出 X 取值小于或等于 x 的概率:
对离散变量, 是 x 及以下所有结果的概率之和(包含 x 本身)。对标准正态分布(standard normal distribution)(见模块 6.2),:PDF 在 −1 左侧的面积,等于 CDF 在 −1 处的高度。
*例:*某基金的季度收益率在 上连续分布,。于是 。
无条件期望值(均值)
无条件均值(unconditional mean),也叫无条件期望(unconditional expectation)或期望值,用概率给每个结果加权:
权重就是概率,加总必须为 1,所以题目没给出的那个概率可以用 1 减去其余概率求得。对结果做简单平均,等于给每个结果 的权重,所以只有各结果等可能时,它才是期望值;概率不相等时,简单平均通常得出不同的答案。第 5 章的样本均值概括的是已经观察到的收益率(事后指标)。期望值用概率给未来可能的结果加权,所以是一种预测(事前指标)。
无条件方差与标准差
**无条件方差(unconditional variance)**是围绕期望值的离差平方的概率加权平均,**无条件标准差(unconditional standard deviation)**是它的平方根:
核心概念
方差的单位是平方单位(例如 %²),所以和收益率做比较的是标准差(单位回到 %)。等价的简便算法是 。
无条件协方差
**无条件协方差(unconditional covariance)**衡量两个随机变量线性关系的方向和强弱。它的符号说明两个变量是否倾向于同时高于或同时低于各自的均值。它的数值大小取决于单位,所以关系的强弱更容易从相关性(correlation)看出(见下面最后一点)。协方差的计算公式:
简便形式是 。
- 协方差为正:两个变量倾向于同向变动;为负:反向变动。
- 在情景(状态)表里, 就是该状态的概率。在联合概率表(joint probability table)里,概率为零的格子贡献为零。
- 单位是两个变量单位的乘积(例如 %² 或小数²),所以数值大小很难解读。除以两个标准差,得到没有单位的相关性:,取值总在 −1 和 +1 之间。
| 指标 | 公式核心 | 单位 | 取值范围 |
|---|---|---|---|
| 方差 | 平方单位 | ||
| 协方差 | 单位的乘积 | 可正可负,无界 | |
| 相关性 | 无 | 到 |
例题详解
| 状态 | 概率 | P 的收益率 | Q 的收益率 |
|---|---|---|---|
| 扩张(Expansion) | 0.20 | 15% | 4% |
| 正常 | 0.50 | 8% | 7% |
| 下行 | 0.30 | −2% | 2% |
- ;。
- (%²),所以 。
- (%²),所以 。
- (%²)。
- 。
*计算器。*BA II Plus 的 DATA/STAT 工作表可以按概率算加权平均数(weighted mean):输入每个结果时,配上与其概率成比例的频数(例如 20、50 和 30)。均值显示为 ,总体(population)标准差显示为 。
常见考试陷阱
- 对结果做简单平均,没有用概率加权。例题中组合 P 的简单平均是 ,而预期收益率(expected return)是 6.4%。
- 忘了开平方:题目问标准差却报了方差(variance),或把小数(0.0035)和百分比平方(35.04)混在一起。例题中组合 P 的方差是 37.24(%²),标准差是 6.10%。
- 用绝对离差代替离差平方,得到的指标不是方差(variance)和标准差。
- 算协方差时没用概率,或把未加权的交叉乘积之和除以状态个数。
- 把协方差和相关性弄混;问“协方差”时,答案带平方单位,也不受 ±1 的限制。
- 以为连续变量在单个点上有正的概率,或以为 PDF 的高度就是概率。
- 把 CDF 的值当作该单个结果的概率,或在 中漏掉结果 x 本身。
答题技巧
- 列出的结果互斥且穷尽、又缺一个概率时,这个概率等于 1 减去其余概率之和。
- 方差可以用 求,不必逐个算离差。
- 对连续变量,区间包不包含端点,概率不变。
本节要点
- 离散随机变量(discrete random variable)有概率质量函数(probability mass function, PMF),单个结果上的概率为正;连续变量有密度函数,任何单点的概率为零,概率赋给区间。
- 只有每个 都在 0 和 1 之间、且概率之和为 1,概率函数才有效。
- CDF 是 ,且 。
- 期望值 ;方差(variance) 的单位是平方单位,标准差是它的平方根。
- 协方差的符号反映共同变动的方向,但其数值大小取决于单位;相关性 没有单位,取值在 −1 和 +1 之间。
随堂小测
A random variable X can take only the values 0, 1, 2 and 3. Which of the following proposed functions is a valid probability function for X?
查看答案和解析
正确答案: C
概率函数必须满足两个条件:每个概率都在 0 和 1 之间(含端点),且所有可能结果的概率加总恰好为 1。只有 同时满足:它给出 0.1、0.2、0.3 和 0.4,每个都在 [0, 1] 内,加总为 1.0。
- 含 的那组:总和 ,但 ,不满足条件 1。
- 常数 :每个值都在 [0, 1] 内,但总和 ,不满足条件 2。
- :;都在 [0, 1] 内,且 ,有效。
其他选项为什么错
- A. 这组概率加总为 1,但概率不可能为负;只满足“加总为 1”这一个条件不够。
- B. 每个概率都在 0 和 1 之间,但合计为 1.20。概率函数必须恰好分完 100% 的概率;四个结果等概率时,每个应为 0.25。
本题要点 每次都检查两个条件:每个 x 都有 ,且 。
模块 6.2
离散概率分布与连续概率分布(Discrete and Continuous Probability Distributions)
LOS 6.b — 金融中主要分布的矩与用途
四个主要矩(moment)
| 矩 | 描述什么 | 基准:正态分布(normal distribution) |
|---|---|---|
| 1. 均值(mean) | 中心位置 | — |
| 2. 方差(variance) | 围绕均值的离散程度(dispersion) | — |
| 3. 偏度(skewness) | 不对称性;正值=右侧长尾 | 0(对称) |
| 4. 峰度(kurtosis) | 尾部相对中心的分量 | 3(超额峰度(excess kurtosis)=峰度 − 3 = 0) |
每种分布最有用的特征,是它刻画什么变量以及它的形状:有界还是无界,对称还是偏斜,薄尾还是厚尾(fat tails)。下面的矩公式供参考。
| 分布 | 均值 | 方差 | 偏度 | 超额峰度 |
|---|---|---|---|---|
| 离散均匀分布( 个结果, 到 ) | 0 | |||
| 二项分布 | ||||
| 泊松分布 | ||||
| 连续均匀分布 | 0 | −1.2 | ||
| 正态分布 | 0 | 0 | ||
| 对数正态分布 | ||||
| 逻辑斯谛分布 | 0 | 1.2 |
离散分布
**离散均匀分布(discrete uniform distribution)。**有限个结果,共 个,每个的概率都是 (例如整数 1 到 8,每个概率 0.125);某个范围内 个结果的概率是 ,CDF 在第 个结果处的值也是 。离散均匀变量取连续整数 时:均值 ,方差(variance) 。对一般的等可能集合(例如 ),直接计算算术平均数(arithmetic mean)和总体(population)方差:这里均值是 3,方差是 。套用连续整数的公式会错误地得到 2。
二项分布(binomial distribution)。统计固定次数 的独立试验中成功的次数;每次试验只有两种结果(成功/失败),成功概率 都相同。只有一次试验的二项变量服从伯努利分布(Bernoulli distribution)。
核心概念
*例:*16 场相互独立的新发行拍卖(auction),每场被全额认购的概率为 0.75:预期全额认购的场数 ;方差 。成功次数的期望值(expected value)不一定是可能出现的结果(10 次试验、 时期望为 4.3);它是多次重复之后成功次数的平均值。
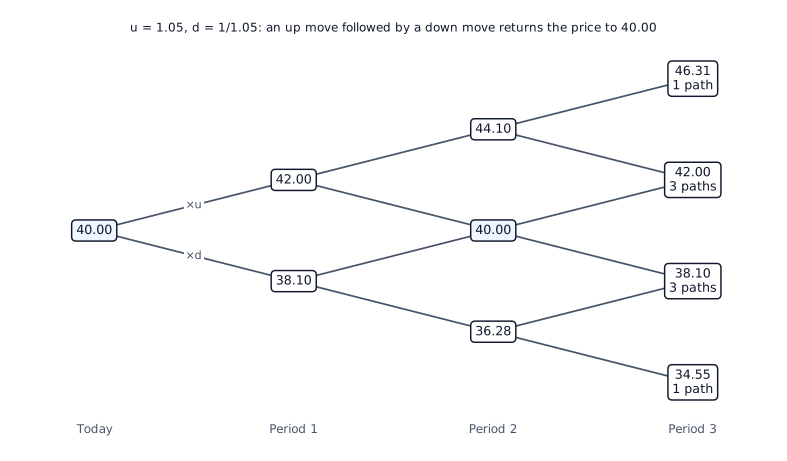
二项模型也用来刻画资产价格:每一步价格乘以上涨因子(up factor) 或下跌因子(down factor) ,所以经过 次上涨和 次下跌后,价格为 。所有可能路径画成一棵概率树(probability tree)(也叫决策树(decision tree))。取 、,价格 40 先涨一次再跌一次(或反过来),都回到 40。
**泊松分布(Poisson distribution)。**事件以已知且恒定的平均速率 独立发生时,统计固定区间内事件发生的次数。它是刻画稀有事件的常用模型,例如每年的违约次数、每月的交易暂停次数或每季度的操作损失次数。
*例:* 次停机/年,,所以至少停机一次的概率是 。对 笔相互独立、违约概率均为 的信贷组合,。当 、 且 保持不变时,二项分布的极限就是泊松分布。
连续分布
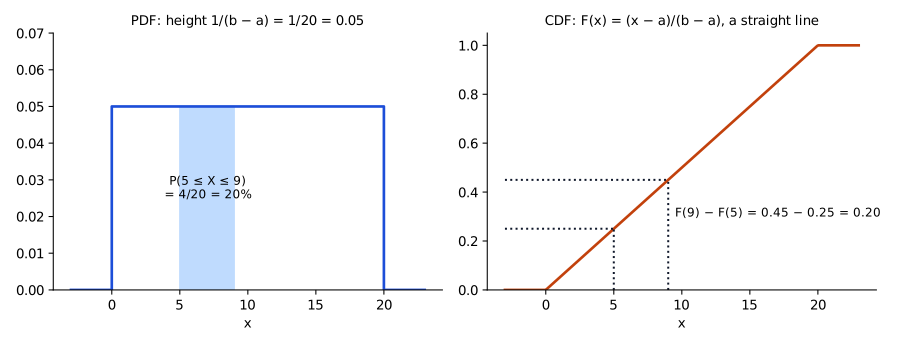
上的连续均匀分布(continuous uniform distribution):宽度相同的子区间概率相同,所以 CDF 是一条直线:,适用于 。
核心概念
偏度(skewness) 0,峰度(kurtosis) 1.8(超额峰度 −1.2)。用于为蒙特卡洛模拟(Monte Carlo simulation)生成随机抽样。例:[0, 20] 上的均匀分布:。
正态分布(也叫高斯分布(Gaussian distribution)),:对称的钟形曲线,由均值和方差(或者说均值和标准差(standard deviation))完全确定(偏度 0,超额峰度 0)。约 68% 的结果落在 ±1σ 之内,约 95% 落在 ±2σ 之内。许多独立变量之和趋向正态分布; 增大时,二项分布也收敛于正态分布。正态分布在两个方向上都无界,所以可能取负值。均值为 0、方差为 1 的正态分布 是标准正态分布(standard normal distribution);它的横轴衡量的是距离均值多少个标准差。
*例:*年收益率服从正态分布,均值 7%,标准差 15%。约 68% 的年份应落在 和 之间,约 95% 落在 −23% 和 37% 之间。收益率 −23% 距离均值 个标准差。曲线对称,所以 之外的 5% 两边平分:约 2.5% 的年份亏损超过 23%。两个区间相减得到中间的部分:约 的结果落在均值以下一个到两个标准差之间,均值以上一个到两个标准差之间也是同样的比例。
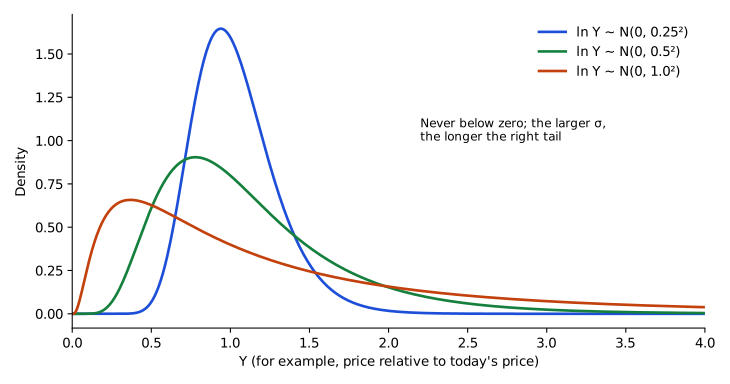
**对数正态分布(lognormal distribution)。** 服从对数正态分布,是指 服从正态分布;等价地说,, 服从正态分布。
- 对任何 都成立,所以对数正态分布以零为下界,永远不取负值。
- 它正偏(右偏)(positively (right) skewed),右侧有长尾。
- 这使它很适合刻画资产价格。服从对数正态分布的价格不会跌破零,所以隐含收益率不会低于 −100%。相比之下,用正态分布刻画价格会允许出现负价格(收益率低于 −100%),这对有限责任(limited liability)资产是不可能的。
- 如果连续复利价格收益率 (不含分配)服从正态分布,价格就服从对数正态分布,因为 ,其中 服从正态分布。跨多个期间时, 是各单期对数收益率之和(见第 1 章),而许多独立收益率之和趋向正态分布。所以即使单期收益率不完全服从正态分布,对数正态价格模型依然拟合得很好。
- 它的两个参数(parameter)是 的均值和标准差,叫作位置参数(location parameter)和尺度参数(scale parameter)。它们不是 本身的均值和标准差: 的均值是 。
- 价格可以用几何布朗运动(geometric Brownian motion)模型来预测。这里 是价格的预期(算术)增长率,不是上面 的位置参数; 是漂移项(drift term):。*例:*,,,:,所以 。
- 考试惯例:用漂移项公式算出的价格,就是 年后的预期价格。现行做法:以 作为预期增长率时,这个数是对数正态价格分布的中位数(median);平均价格是 (这里为 ),因为右偏,所以更高。
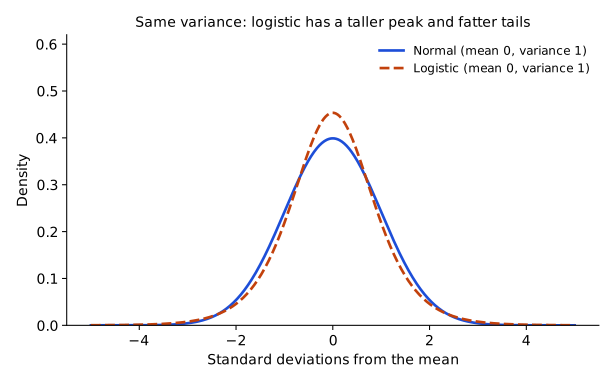
逻辑斯谛分布(logistic distribution)。和正态分布一样是对称的钟形(偏度 0),但尾部更厚(fatter tails)。它的超额峰度(excess kurtosis)为 +1.2,所以与方差相同的正态分布相比,极端结果更容易出现。方差是 ,其中 为尺度参数。逻辑斯谛分布用于逻辑斯谛回归(logistic regression)(因变量(dependent variable)是二元的 0/1)和机器学习(machine learning, ML)。
按问题选择分布
| 情形 | 分布 |
|---|---|
| 固定次数的独立是/否试验中的成功次数 | 二项分布 |
| 一个区间内以恒定速率发生的稀有事件次数 | 泊松分布 |
| 有限个等可能的结果 | 离散均匀分布 |
| 在某个范围内为模拟生成随机抽样 | 连续均匀分布 |
| 收益率、检验统计量、许多变量之和 | 正态分布 |
| 资产价格(非负、右偏) | 对数正态分布 |
| 二元结果的回归;对称但厚尾的数据 | 逻辑斯谛分布 |
常见考试陷阱
- 把泊松分布说成“时间”或“等待时间”分布:它刻画的是一个区间内事件发生的次数。
- 以为对数正态分布(lognormal distribution)是负偏或对称的;它是正偏的,以零为界。
- 把对数关系弄反: 服从对数正态分布(lognormal distribution),则 服从正态分布(不是对数正态); 服从正态分布,则 服从对数正态分布。
- 说正态分布(normal distribution)适合刻画价格,“因为它只允许价格跌到零”。正态分布无界,会允许负价格。
- 说逻辑斯谛分布有偏度(skewness):它的偏度为零,与正态分布(normal distribution)的区别在于峰度(尾部更厚)。
- 试验次数不固定、或每次试验的成功概率在变时,仍套用二项分布。
答题技巧
- 从题目措辞判断分布:固定次数试验中的成功次数是二项分布,区间内的事件次数是泊松分布,模拟用的随机抽样是连续均匀分布,资产价格是对数正态分布。
- 正态分布的区间:约 68% 的结果在 ±1σ 之内,95% 在 ±2σ 之内,所以每一侧约有 2.5% 落在 2σ 之外,约 13.5% 落在 1σ 与 2σ 之间。
- 泊松变量至少发生一次的概率是 。
本节要点
- 二项变量统计 次独立试验( 不变)中的成功次数:,;单次试验就是伯努利分布。
- 泊松变量统计一个区间内以恒定速率 发生的事件次数,均值和方差(variance)都等于 。
- 上的连续均匀变量,。
- 正态分布(normal distribution)对称,由均值和方差(variance)完全确定,在两个方向上都无界。
- 服从正态分布时, 服从对数正态分布(lognormal distribution):以零为下界、正偏,适合刻画资产价格。
- 逻辑斯谛分布和正态分布(normal distribution)一样对称,但尾部更厚(超额峰度 +1.2)。
随堂小测
Each week, the fixed-income desk at Corrib Securities submits competitive bids in 25 separate government bond auctions. The desk's chance of winning an allocation is 0.36 in every auction, and the result of one auction does not affect any other. For the number of auctions the desk wins in a week, the expected value and the variance are, respectively:
查看答案和解析
正确答案: C
中标场数是一个二项随机变量(random variable):独立试验的次数固定(25 场拍卖),每次只有两种结果(中标或落标),成功概率相同()。它的均值是 ,方差(variance)是 。
(标准差是 。)和任何离散计数一样,均值 9.0 是长期来看每周平均中标的场数,并不保证一定出现。
其他选项为什么错
- A. 16.0 用的是一场拍卖落标的概率,,算出的是预期落标场数。方差 5.76 是对的,因为不管把哪种结果定义为成功, 都一样。
- B. 均值 9.0 是对的,但 2.40 是标准差 ,即方差的平方根。
本题要点 二项分布:,。把要计数的那个结果定义为“成功”;题目问方差时,不要停在标准差。
模块 6.3
条件期望与贝叶斯更新(Conditional Expectations and Bayesian Updating)
LOS 6.c — 联合分布,以及条件期望、条件方差和条件协方差
联合概率与边际概率
联合概率分布(joint probability distribution)给出两个或多个变量每一种结果组合的概率;两个变量时称为二元分布(bivariate)。离散变量的联合概率分布常用列联表(contingency table)表示。行合计和列合计就是边际分布(marginal distributions)。
对一般的两个变量,**联合累积分布函数(joint cumulative distribution function)**给出两个变量都小于或等于给定值的概率:。描述一个二元分布,要用每个变量的均值和方差(variance),再加上两者如何共同变动(它们的协方差(covariance)或相关性(correlation))。
| 400 家上市公司 | 科技类 | 非科技类 | 合计 |
|---|---|---|---|
| 收益率 > 10% | 64 | 56 | 120 |
| 收益率 ≤ 10% | 96 | 184 | 280 |
| 合计 | 160 | 240 | 400 |
- 边际概率:;。
- 联合概率(joint probability):。
- 条件概率(conditional probability):,只用科技类那一列。
条件均值、条件方差和条件协方差
条件期望(conditional expectation) 是 在条件 成立时的期望值(expected value),读作“给定 S 时 X 的期望值”。根据新信息修正后的预测就是条件期望;例如,“如果合并获批,我对每股收益(earnings per share, EPS)的估计上调到 $4.20”。
条件方差(conditional variance)衡量的是围绕条件均值(conditional mean) 的离散程度(dispersion),而不是围绕无条件均值(unconditional mean) :
**条件协方差(conditional covariance)**对两个变量按同样的方式定义,用的是条件概率和条件均值。它和单个变量的条件方差是两个不同的概念。
**条件分布(conditional distribution)**描述的是:把联合分布中其他变量限定在某些取值之后,剩下那个变量的分布。加上条件会改变相关的概率分布(probability distribution),所以期望值和方差都可能改变。
| 概念 | 使用的概率 | 离差相对于 |
|---|---|---|
| 无条件均值/方差 | 所有结果上的 | |
| 条件均值/方差 | ,只取与 一致的结果 | |
| 联合概率 | —(不是期望) |
概率树
概率树(probability tree)展示先后发生的结果;一条完整路径的概率等于沿途各分支概率的乘积。无条件期望值用路径概率给每个终点节点加权,路径概率就是该路径上各分支概率的乘积。加上一个条件(例如“第 1 期价格下跌”)就是剪枝。只保留从已观察到的节点出发的分支,它们的分支概率就成了条件概率。
*例:*某股票现价 50,两期中每一期都以 0.6 的概率上涨 10%,以 0.4 的概率下跌 10%(各期变动相互独立)。
- 期末价格:60.50(概率 0.36),49.50(概率 0.48,两条路径),40.50(概率 0.16)。无条件 。
- 给定 (第 1 期下跌):;,所以条件标准差(standard deviation)是 4.41。
- 给定 :。用分支概率给两个条件期望加权,就回到无条件值:。
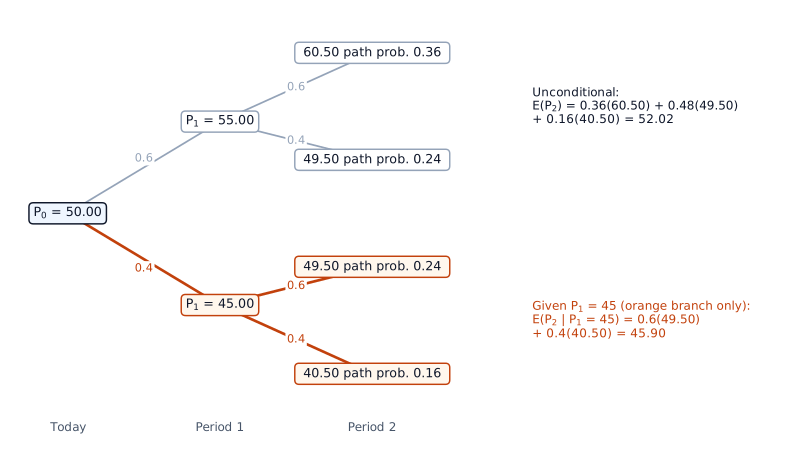
常见错误是用联合(路径)概率给剩下的结果加权,例如 ,得到 18.36。这个数是 ,不是条件期望。
LOS 6.d — 用贝叶斯公式更新概率
贝叶斯公式(Bayes' formula)在观察到新信息 之后,把某个事件的先验概率(prior probability)(英文也叫 a priori probability)修正为后验概率(posterior probability)。它来自乘法法则(multiplication rule) :把联合概率(joint probability)用两种方式写出,得到 ,再除以 ,得到
核心概念
分母是信息的无条件概率(unconditional probability):信息与每个状态的联合概率之和。
可以用 LOS 6.c 中 400 家公司的表格验证这个公式。直接数:收益率超过 10% 的 120 家公司中有 64 家是科技公司,所以 。贝叶斯公式从反方向的条件概率出发,得到同样的结果:。
使用贝叶斯公式(Bayes' formula):
- 写出先验概率 及其补集概率 。
- 写出似然概率 和 ;如果信息是“没有发生”的事件,取补集。
- 相乘,得到 与每个状态的联合概率。
- 把联合概率相加,得到 。
- 后验概率 = 所关注状态的联合概率 ÷ 。
*例:*某数据库的基金经理中,30% 有投资能力。有能力的经理在某一年跑赢基准(benchmark)的概率是 0.75;没有能力的是 0.40。某位经理跑赢了基准。她有能力的概率是多少?
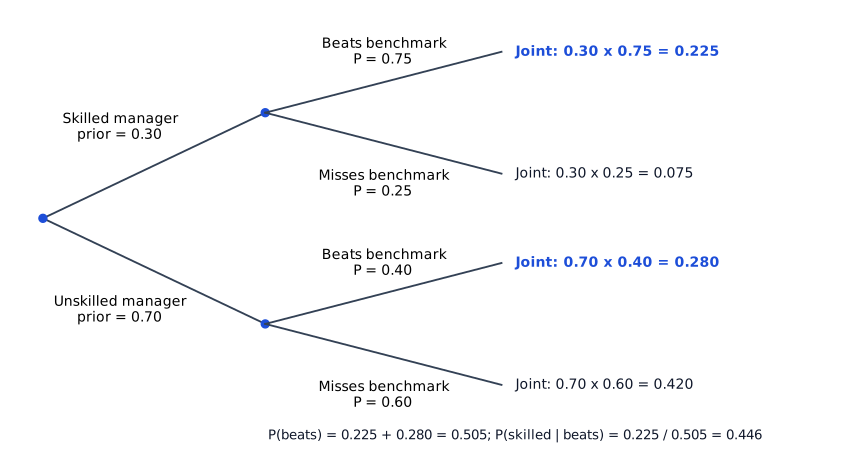
这条证据把概率从 30% 的先验提高到约 45%;但没有能力的经理占多数,一个好年份远不足以证明有能力。
常见考试陷阱(LOS 6.c 和 6.d)
- 把联合概率(joint probability) (第 3 步)当作答案,没有除以 。在基金经理的例子中,这会得到 0.225,而不是 0.446。
- 把信息的无条件概率(unconditional probability) (第 4 步)当作后验概率(posterior probability)。同一个例子中会得到 0.505。
- 把 和 弄混;两者通常相差很大。
- 只比较似然概率,,忽略了先验概率(prior probability)。在上例中会得到 。
- 信息是“某事没有发生”时,忘了取补集。
- 在概率树中,用联合路径概率求条件期望,或对所有终点节点做等权平均。
- 围绕无条件均值(unconditional mean)计算条件方差。
答题技巧
- 用贝叶斯公式时,每个状态写一行“先验 × 似然”,各行相加得到 ,再用所关注状态那一行除以这个合计。
- 验算条件期望:用分支概率给各条件期望加权,必须回到无条件期望。
本节要点
- 联合概率(joint probability)是 ,边际概率是行合计和列合计,条件概率(conditional probability)只用与条件一致的结果。
- 条件期望是 ,条件方差围绕 计算。
- 在概率树中,路径概率等于各分支概率的乘积。
- 贝叶斯公式(Bayes' formula)是 ,其中 是信息与每个状态的联合概率(joint probability)之和。
- 和 通常不同,后验概率(posterior probability)仍然取决于先验概率(prior probability)。
随堂小测
A high-yield portfolio holds 40% BB-rated bonds and 60% B-rated bonds. Historically, 10% of BB-rated bonds and 30% of B-rated bonds default within five years. If a bond chosen at random from the portfolio defaults within five years, the probability that it was BB-rated is closest to:
查看答案和解析
正确答案: B
这是一次贝叶斯更新:用“债券违约了”这条信息,修正债券为 BB 级的先验概率(0.40)。后验概率(posterior probability)等于“BB 级且违约”的联合概率(joint probability)除以违约的无条件概率。
其他选项为什么错
- A. 0.100 是似然概率 。题目问的是反方向的条件概率(conditional probability),即后验概率 。
- C. 0.333 是两个违约率之比();它忽略了组合权重(先验概率)和违约的无条件概率。
本题要点 。先算出联合概率,相加得到分母,再相除。
练习题
A consultant at Northgate Partners has estimated the scenario returns shown in the table below. The standard deviation of returns on Fund Alder is closest to:
| Scenario | Probability | Return on Fund Alder | Return on Fund Birch |
|---|---|---|---|
| Boom | 20% | 19% | 12% |
| Expansion | 25% | 15% | 11% |
| Stagnation | 35% | 9% | 10% |
| Contraction | 20% | 1% | 8% |
查看答案和解析
正确答案: B
Fund Alder 的标准差,是 Alder 各情景收益率相对 Alder 预期收益率的离差平方的概率加权平均,再开平方。Fund Birch 那一列与本题无关。
1. Alder 的预期收益率
2. 方差(百分比单位)
(用小数表示为 0.003819)
3. 标准差
其他选项为什么错
- A. 1.34% 是 Fund Birch 的标准差,用错了列(方差 1.7875 %²)。
- C. 6.78% 忽略了概率,把四个情景当作等可能(均值 11%,方差 46 %²)。
本题要点 两资产表格要看准列,并用情景概率给离差平方加权。
A commodity desk simulates thousands of possible copper price paths and wants to be certain that no simulated price is ever negative. Which distribution for the price level is best suited to this goal?
查看答案和解析
正确答案: C
对数正态分布(lognormal distribution)以零为下界,永远不会生成负价格,所以它是刻画资产价格水平的常用选择。正态分布和逻辑斯谛分布都向负无穷延伸。
其他选项为什么错
- A. 正态分布没有下界,模拟路径足够多时,总会有一些价格变成负数;它不适合直接刻画价格水平。
- B. 逻辑斯谛分布同样对称、无界,既可以取正值,也可以取负值(而且它尾部更厚,抽到极端负值的可能性比正态分布还大)。
本题要点 模拟价格绝不能为负时,用对数正态分布刻画价格水平。
本章题库共 46 道题。 去题库全部练习。
本章要点
- 每次都检查两个条件:每个 x 都有 ,且 。
- 两资产表格要看准列,并用情景概率给离差平方加权。
- 二项分布:,。把要计数的那个结果定义为“成功”;题目问方差时,不要停在标准差。
- 模拟价格绝不能为负时,用对数正态分布刻画价格水平。
- 。先算出联合概率,相加得到分母,再相除。