数量方法 · 第 7 章
估计与假设检验(Estimation and Hypothesis Testing)
CFA 一级 · 数量方法 · 第 7 章 · 约 1 小时 8 分钟
本章学习目标
- LOS 7.a 解释中心极限定理,并用它构建置信区间、计算参数法风险价值,以及在各种抽样方法之间做选择。
- LOS 7.b 解释假设检验的组成部分(假设、检验统计量、显著性水平、决策规则)、第一类错误和第二类错误以及检验功效;构建并解读检验。
- LOS 7.c 比较参数检验和非参数检验,判断什么时候适合用非参数检验,构建并解读斯皮尔曼秩相关检验和卡方独立性检验。
模块 7.1
中心极限定理、置信区间与抽样(The Central Limit Theorem, Confidence Intervals, and Sampling)
本章从样本推断总体(population):先看中心极限定理(central limit theorem, CLT)下样本均值的表现,再讲置信区间(confidence interval, CI)怎么构建、样本怎么抽取。随后列出假设检验(hypothesis testing)的步骤、各种参数检验(parametric test)的检验统计量(test statistic)、两类错误,以及用于秩和类别数据的非参数检验(nonparametric test)。
LOS 7.a — 中心极限定理、置信区间与抽样
中心极限定理(CLT)
或 这样的**总体参数(population parameter)是一个固定的数,通常未知。 或 这样的样本统计量(sample statistic)**由实际抽到的样本算出,换一个样本取值就不同,所以它本身是一个随机变量(random variable)。同样大小的所有可能样本给出的统计量取值,构成该统计量的抽样分布(sampling distribution)。
反复抽取容量为 的简单随机样本(simple random samples),总体均值为 、方差(variance) 有限。中心极限定理(CLT)指出:不管总体本身是什么形状(偏斜、平坦、起伏不平),样本均值的抽样分布(sampling distribution of the sample mean) 都会随着 变大而趋近正态分布(normal distribution):
核心概念
由此得到三点:
- 所有可能样本均值的均值等于总体均值:。
- 样本均值的方差等于总体方差除以样本容量,即 , 越大,方差越小。
- CLT 描述的是样本均值的分布。单个观测值仍保持总体的形状;样本标准差(standard deviation)的分布,CLT 不涉及。
标准误(standard error)与抽样误差
**抽样误差(sampling error)是样本统计量与它所估计的总体参数之差(如 )。它的典型大小用样本均值的标准误(standard error of the sample mean)**衡量:
核心概念
未知时用 代替,得到的是标准误的估计值。标准差描述单个观测值围绕均值的分散程度,样本变大并不会让它变小。标准误描述 估计 的精确程度。
计算器: 有原始数据时,在 DATA 工作表输入观测值,在 STAT 工作表(1-V)读出样本标准差 ,再除以 。
例: 某季度收益率总体的 。 时,;样本扩大到四倍(144 个),标准误减半,降到 1.5%。
估计量的理想性质
| 性质 | 含义 |
|---|---|
| 无偏性(Unbiased) | 估计量的期望值(expected value)等于参数(样本均值是 的无偏估计量)。 |
| 有效性(Efficient) | 在无偏估计量中抽样方差最小。既无偏又有效的估计量是最小方差无偏估计量(minimum variance unbiased estimator, MVUE);在样本数据的线性组合构成的无偏估计量中,方差最小的那个是最佳线性无偏估计量(best linear unbiased estimator, BLUE)。 |
| 一致性(Consistent) | 增大时准确度提高(标准误趋向于零)。 |
| 稳健性(Robust) | 对异常值(outliers)或非正态数据不敏感(样本均值不稳健)。 |
置信区间
点估计(point estimate)是单个数值(如 )。置信区间是围绕点估计构建的一个范围,它以给定的置信水平(confidence level) 包含真实参数,其中 是显著性水平(significance level):
| 情形 | 可靠性因子(reliability factor) | 的区间 |
|---|---|---|
| 正态总体, 已知 | ||
| 正态(或近似正态)总体, 未知(用 ); 较小时必须用这一种 | ,自由度(degrees of freedom, df)为 | |
| 未知,大样本(),总体形状不限(CLT) | 首选 ;也可用 近似 | ,或作为大样本近似的 |
双尾 z 可靠性因子 :90% 用 1.65(未取整为 1.645),95% 用 1.96,99% 用 2.58(未取整为 2.576)。区间宽度由三件事决定:置信水平越高(可靠性因子越大),区间越宽;总体越分散,区间越宽;样本越大(标准误越小),区间越窄。
**学生 t 分布(Student's t-distribution)**呈钟形、对称,但尾部比正态分布厚;它的临界值(critical value)大于 z 值(区间更宽),并随自由度上升向 z 值靠拢。95% 区间的 t 可靠性因子:10 个 df 时为 2.228,20 个 df 时为 2.086,30 个 df 时为 2.042,而 z 为 1.96。查 t 表时,用单尾面积(双侧区间取 )和 个自由度。
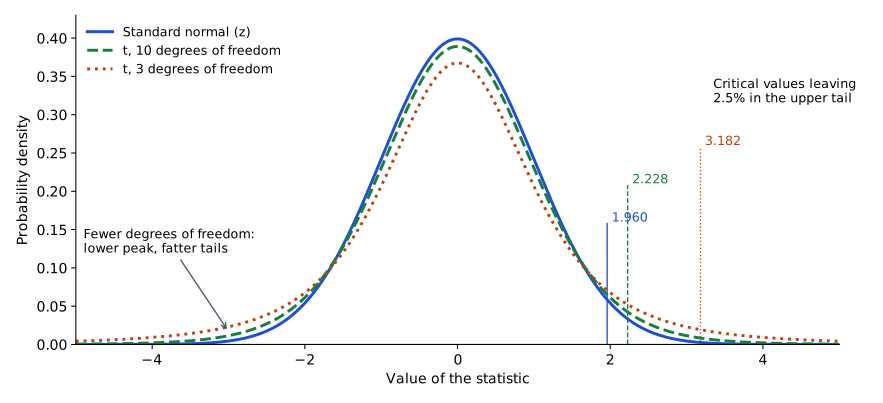
例(σ 已知): 49 个观测值,,,标准误 ;95% 区间 至 。 例(σ 未知,小样本): 来自假定正态总体的 10 个观测值给出 。95% 可靠性因子用 ,不用 1.96。如果小样本来自明显非正态的总体,t 区间和 z 区间都不可靠。
风险价值(VaR):单尾区间
**风险价值(value at risk, VaR)**是在给定期间内、以给定(较小)概率达到或超过的损失。“每日 1% VaR 为 $0.47 million”的意思是:任何一天亏损 $0.47 million 或更多的概率为 1%(等价地说,有 99% 的把握损失小于这个数)。VaR 是给定概率下的最小损失;更大的损失仍可能发生,所以它不是最坏情况下的损失。
参数法(parametric method)(收益率服从正态分布,假定平均收益率为零)下:
整个 放在一侧尾部:,(未取整为 1.645),。 用百分比、组合价值用美元时,VaR 是美元损失;去掉组合价值,VaR 就表示为占组合的百分比。 例: $25 million 的组合,每日 ,每日 1% VaR ,即组合的 1.864%。
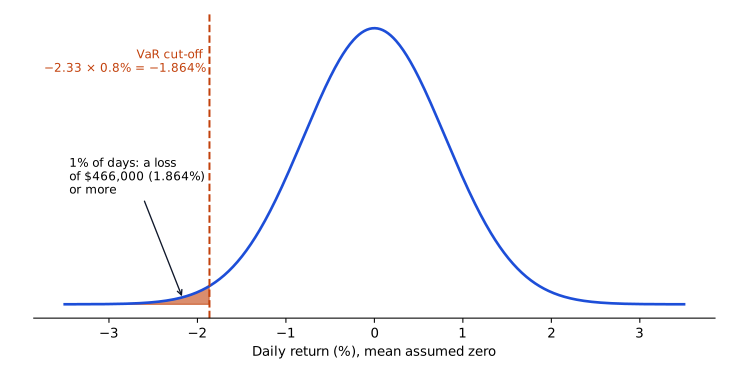
缺点:收益率常常偏斜或厚尾,参数随时间变化,历史数据可能反映不了新情况,对非线性收益(期权)处理得不好。
抽样方法
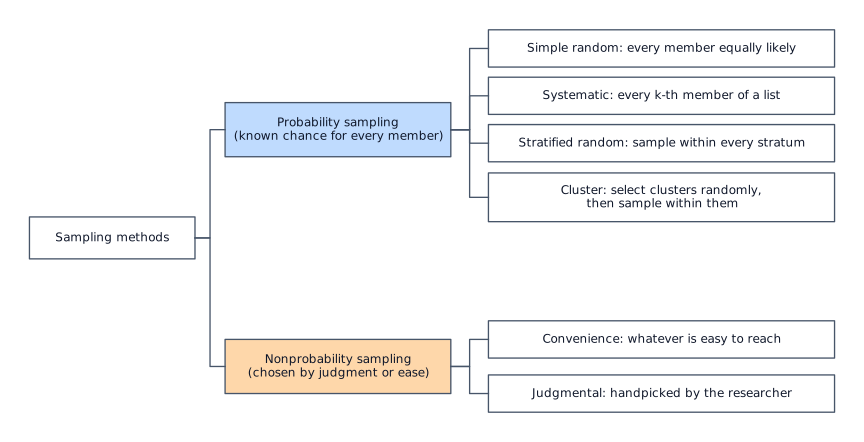
| 类别 | 方法 | 样本怎么抽 |
|---|---|---|
| 概率抽样(Probability sampling)(每个成员被抽中的概率已知且不为零) | 简单随机抽样(Simple random sampling) | 从完整名单中随机抽取,每个成员被抽中的机会相同(因此容量为 的每一种可能样本出现的概率都相等)。仅仅个体机会相等还不够:随机起点的系统抽样也让每个成员机会相同。 |
| 系统抽样(Systematic sampling) | 在总体名单中每隔 个选一个。 | |
| 分层随机抽样(Stratified random sampling) | 按某个特征(行业、规模、评级)把总体分成若干层(strata);在每一层内随机抽样,通常按该层在总体中的权重分配样本量;再把结果合并。 | |
| 整群抽样(Cluster sampling) | 把总体分成若干群,每个群都与总体相似;随机选出一些群,在群内抽样。群足够大时 CLT 适用。 | |
| 非概率抽样(Nonprobability sampling) | 便利抽样(Convenience sampling) | 用最容易接触到的对象(如同一办公室的同事);成本低,但很可能不具代表性。 |
| 判断抽样(Judgmental sampling) | 研究者凭经验和判断亲自挑选样本;可能带入研究者的偏差,但遇到复杂的研究问题时,专家判断会有帮助。 |
概率抽样一般更准确;非概率抽样(Nonprobability sampling)成本更低。分层抽样和整群抽样(Cluster sampling)都先把总体分组。分层抽样从每一组都抽,所以样本保持了总体在各组之间的构成;整群抽样只用其中一部分组,组与组之间的差异可能丢失。
样本本身不具代表性,CLT 也救不回来。
常见考试陷阱
- CLT 要求方差(variance)有限、 足够大,这里的 是每个样本的容量;同样小的样本多抽几次没有用。CLT 不要求总体服从正态分布,它描述的是样本均值。
- 标准误(standard error)除以 ,不是除以 。、 时,除以 36 得 0.5%,正确答案是 3%。
- 双侧 95% 用 1.96;单尾 5%(VaR)用 1.645。每次都要看清是几个尾。在上面的 VaR 例子里,误用双尾 1% 的 2.58 会得到 $516,000,而不是 $466,000。
- “先随机抽取,再每隔一个保留一个”仍是简单随机抽样(Simple random sampling):在已经随机的序列中保留固定位置,选择过程仍然完全随机。系统抽样(Systematic sampling)是指在一份固定、排好序的总体名单上每隔 个取一个。
- 先分组、再在每组内抽样是分层抽样;亲手挑选是判断抽样(Judgmental sampling);挑最容易接触到的是便利抽样(Convenience sampling)。
答题技巧
- 样本容量扩大到四倍,标准误减半。
- 可靠性因子:双尾 90%、95%、99% 分别用 1.65、1.96、2.58;单尾 10%、5%、1%(VaR)分别用 1.28、1.65、2.33。
- 置信水平越高区间越宽,样本越大区间越窄;方向说反的选项可以直接排除。
本节要点
- 根据中心极限定理(CLT),只要总体方差(variance)有限,容量 的样本均值近似服从均值为 、方差为 的正态分布。
- 样本均值的标准误为 ,也可以是 :后者用于 未知的情形。
- 置信区间 = 点估计(point estimate) ± 可靠性因子 × 标准误(standard error)。t 可靠性因子(自由度 )用于 未知的情形。
- 理想的估计量具有无偏性、有效性、一致性和稳健性。
- 参数法 VaR 为 组合价值,整个 放在一侧尾部;它是给定概率下的最小损失,不是最坏情况下的损失。
- 简单随机抽样(Simple random sampling)、系统抽样(Systematic sampling)、分层抽样和整群抽样(Cluster sampling)属于概率抽样;便利抽样(Convenience sampling)和判断抽样(Judgmental sampling)属于非概率抽样(Nonprobability sampling)。
随堂小测
A fixed-income analyst splits the universe of investment-grade corporate bonds into five credit-rating buckets. From each bucket she randomly draws a number of bonds proportional to that bucket's share of the universe and then combines the draws into one sample of 400 bonds. Her approach is best described as:
查看答案和解析
正确答案: C
分析师先按某个分类标准(这里是信用评级(credit rating))把总体分成若干子组(层),再在每一层内随机抽样,最后把结果合并。这就是分层随机抽样(Stratified random sampling)。每一层按它在总体中的权重抽取,样本的评级构成就和总体一致。
其他选项为什么错
- A. 简单随机抽样(Simple random sampling)是从一份不分组的名单中抽取,债券池里每只债券被抽中的机会相同;本题先把总体分成几个评级档,再对每一档分别抽样。
- B. 系统抽样(Systematic sampling)是在排好序的总体名单上每隔 k 个选一个。分析师做的是在每个评级档内随机抽取。
本题要点 先把总体分组,再在每一组内随机抽样,就是分层随机抽样。
模块 7.2
总体均值的假设检验(Hypothesis Tests of the Population Mean)
LOS 7.b — 总体均值的假设检验
假设检验做什么
**假设(hypothesis)**是关于总体参数(parameter)取什么值的一个说法(例如“这个策略的日均收益率为零”)。用一个样本(sample)来判断:数据是否提供了足够的证据,可以拒绝这个说法。
- **参数检验(parametric tests)**对总体(population)的分布做出假定,检验的是分布的参数(均值、方差)。
- **非参数检验(nonparametric tests)**对分布的假定很少,或者检验的对象不是参数(秩、类别计数);模块 7.4 专门讲。
四个步骤
- 写出原假设(null hypothesis, H0) 和备择假设(alternative hypothesis, Ha) 。
- 确定**检验统计量(test statistic)**及其分布。
- 设定显著性水平(significance level) 。
- 确定决策规则(decision rule)(即临界值(critical value)),然后比较。
假设。 原假设通常是研究者希望拒绝的说法,并且总是含有等号(=、≤ 或 ≥)。备择假设是研究者想要找证据支持的结论。两者互斥,且合起来覆盖所有可能。
| 要找的证据 | 检验 | 拒绝域(rejection region) | ||
|---|---|---|---|---|
| 均值不等于 (方向不限) | 双尾检验(two-tailed test) | 两侧尾部,各 | ||
| 均值比 大 | 单尾检验(one-tailed test) | 右侧尾部,全部 | ||
| 均值比 小 | 单尾检验 | 左侧尾部,全部 |
均值的检验统计量
检验统计量衡量样本均值离假设值有多少个标准误(standard error):
核心概念
用 计算、且总体服从正态分布(normal distribution)(或近似正态)时,统计量服从自由度(degrees of freedom)为 的 t 分布(t-distribution);大样本()时,即使总体不是正态的,CLT 也让 t 检验(t-test)近似成立,用 z 统计量(z-statistic)(标准正态)近似也可以。来自明显非正态总体的小样本,两种检验都不适用。总体服从正态分布且方差(variance)已知时,统计量用 计算,不论样本多大都服从标准正态分布(standard normal distribution);z 临界值没有自由度。符号有意义:统计量为负,说明样本均值低于 。
z 临界值(考试取值;括号内为三位小数的值):
核心概念
| 显著性水平 | 双尾检验 | 单尾检验 |
|---|---|---|
| 10% | ±1.65 (1.645) | 1.28 (1.282) |
| 5% | ±1.96 | 1.65 (1.645) |
| 1% | ±2.58 (2.576) | 2.33 (2.326) |
决策规则。 检验统计量落入拒绝域(超过临界值)时拒绝 ;否则不能拒绝(fail to reject) 。原假设永远不会被“接受”;不能拒绝只说明数据的证据不够强,拒绝不了它。**置信水平(confidence level)**为 。双尾检验(two-tailed test)的规则等价于一个置信区间(confidence interval, CI): 被拒绝,当且仅当样本均值落在以假设值为中心的区间 (临界值 标准误)之外。
临界值取决于三件事:检验统计量的分布(z,或带自由度的 t)、显著性水平,以及检验是单尾还是双尾。例如在 时,统计量 1.75 超过右尾检验的临界值(1.65),但没有超过双尾检验的临界值(1.96),两种检验的结论不同。
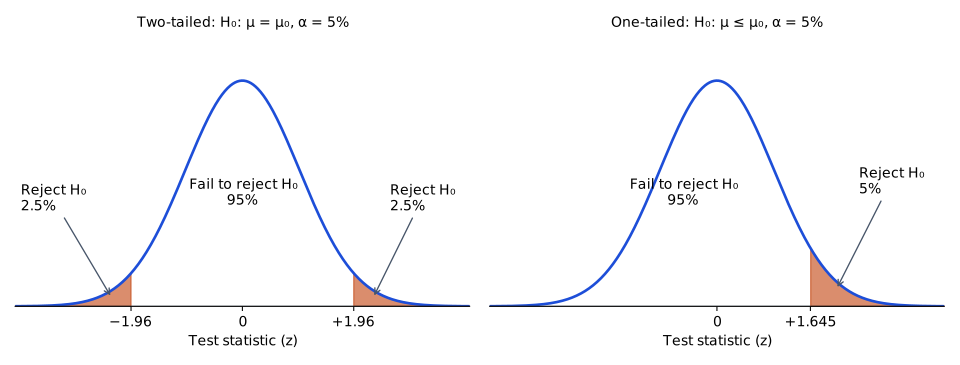
例: 81 个日收益率的样本,,;检验 ,双尾,。标准误为 ,统计量为 。2.10 大于 1.96,拒绝 。如果 (临界值 ±2.58),就不能拒绝 。
什么会推动统计量变化。 样本均值高于 时,样本均值上升、标准差(standard deviation)下降或样本容量增大(标准误变小),统计量(以及拒绝的概率)都会上升。
第一类错误、第二类错误与检验功效
| 为真 | 为假 | |
|---|---|---|
| 拒绝 | 第一类错误(Type I error),即假阳性(false positive);概率 = | 正确决策;概率 = 检验功效(power of the test) |
| 不能拒绝 | 正确决策;概率 = (置信水平) | 第二类错误(Type II error),即假阴性(false negative);概率 = |
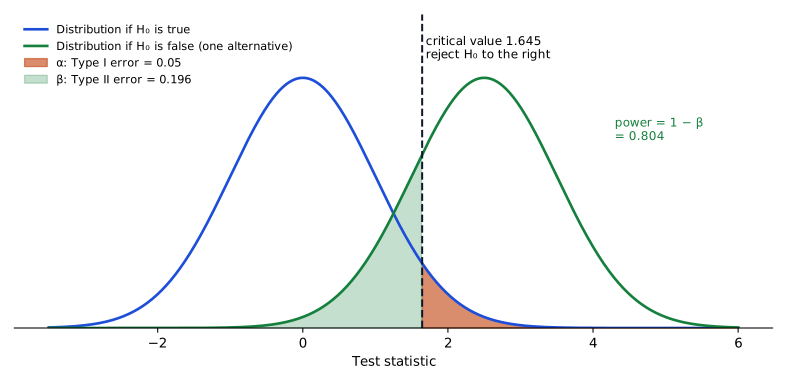
- 显著性水平就是犯第一类错误(Type I error)的概率,即原假设为真却因偶然被拒绝的概率。
- 检验功效是正确拒绝错误原假设的概率:功效 。
- 一次检验只可能犯一种错误:第一类错误要求原假设为真,第二类错误(Type II error)要求原假设为假。
- 此消彼长:样本容量和检验统计量不变时,降低 (如从 5% 降到 1%)会提高犯第二类错误的概率,降低功效;在这种情况下要提高功效,就得接受更高的 。 更低还意味着临界值更大,对应的置信区间更宽。
- 考试惯例:给定 ,只有增大样本容量才能提高功效,这样犯第二类错误的概率下降,而犯第一类错误的概率仍为 。现行说法:在给定的 下,噪声更小的数据(标准差更低)或功效更强的检验统计量也能提高功效。
- 犯第二类错误的概率同时取决于 和样本容量,但两者的关系并不简单,实际中这个概率很难算出。同一个假设可以用几种检验统计量时,通常选功效最强的那个。
例: 垃圾邮件过滤器检验 :“这封邮件是正常邮件。”把正常邮件放进垃圾箱,是拒绝了为真的原假设(第一类错误);放过垃圾邮件,是没有拒绝错误的原假设(第二类错误)。
例题详解:置信区间与单尾检验
64 个月度收益率的样本,均值 0.85%,标准差 2.4%。总体标准差未知。构建均值的 95% 置信区间,再在 5% 的水平上检验平均收益率是否高于 0.5%。
第 1 步:标准误 。
第 2 步:95% 置信区间。,用 z 可靠性因子近似即可:,区间为 0.262% 至 1.438%。自由度为 63 的 t 可靠性因子是 1.998,区间略宽,为 0.251% 至 1.449%。
第 3 步:在 5% 的水平上检验平均收益率是否高于 0.5%:,。这是单尾检验(one-tailed test),5% 全部放在右侧尾部,临界值为 1.65(自由度为 63 的 t 值为 1.669)。
第 4 步:检验统计量 。
第 5 步:1.17 低于临界值,不能拒绝 :样本没有显示平均收益率高于 0.5%。
第 6 步:如果真实均值高于 0.5%,这个决策就是第二类错误。不可能犯第一类错误,因为 没有被拒绝。
常见考试陷阱
- 5% 的显著性水平(significance level)对应 95% 的置信水平(confidence level);“95% 的显著性”是把两个概念弄混了。
- 双尾 5% 检验犯第一类错误(Type I error)的概率是 5%;2.5% 只是每侧尾部的面积。
- 功效是 ; 是置信水平(confidence level)。
- 双尾检验(two-tailed test)的 用“≠”;“<”或“>”表示单尾检验(one-tailed test)。
- 看清是哪一侧:对 ,只有统计量低于负的临界值(critical value)时才拒绝原假设(null hypothesis, H0)。
- 双尾 10% 检验和单尾 5% 检验的临界值(critical value)都是 1.65,因为两者在临界值之外的尾部面积都是 5%。
答题技巧
- 含等号的假设是 。
- 双尾 10% 检验和单尾 5% 检验的临界值都是 1.65。
- 双尾检验中, 被拒绝,当且仅当样本均值落在 临界值 × 标准误之外,所以置信区间可以直接回答检验问题。
本节要点
- 总是含有等号,通常是研究者希望拒绝的说法; 是研究者要找证据支持的说法。
- 检验统计量(test statistic) = (样本均值 − )÷ 标准误,服从自由度为 的 t 分布(用 计算时)。
- 统计量超过临界值(critical value)时拒绝 ;否则结论是不能拒绝,原假设(null hypothesis, H0)永远不会被接受。
- 第一类错误(Type I error)是拒绝为真的原假设(null hypothesis, H0),概率为 ;第二类错误(Type II error)是没有拒绝错误的原假设,概率为 ;功效为 。
- 样本容量不变时, 越低,越容易犯第二类错误(Type II error),功效越低。
随堂小测
A researcher keeps her sample size unchanged but tightens the significance level of her test from 5% to 1%. As a result, the probability of:
查看答案和解析
正确答案: A
降低显著性水平(significance level),犯第一类错误(Type I error)的概率随之降低。样本容量固定时,拒绝域(rejection region)缩小,错误的原假设(null hypothesis, H0)更不容易被拒绝:犯第二类错误(Type II error)的概率上升,检验功效下降。
其他选项为什么错
- B. 拒绝为真的原假设是第一类错误,它的概率就是显著性水平,从 5% 降到 1%。
- C. 没有拒绝错误的原假设是第二类错误;样本容量不变而降低 α,它的概率会上升。原假设永远不会被“接受”,检验只能不拒绝它。
本题要点 固定时, 越低, 越高,功效越低。
模块 7.3
其他参数假设检验(Other Parametric Hypothesis Tests)
LOS 7.b — 其他参数假设检验
下面每一种检验都和单个均值的检验一样,分四步走(假设、检验统计量、显著性水平(significance level)、决策规则(decision rule))。变化的是检验统计量(test statistic),以及临界值(critical value)所依据的分布。
各种检验一览
核心概念
| 检验对象 | 检验统计量 | 分布 / 自由度(degrees of freedom) | 主要假定 |
|---|---|---|---|
| 单个均值 | t,( 较大时用 z) | 总体(population)服从正态分布,或大样本 | |
| 均值之差(difference between means)(独立样本) | ,其中合并方差 | t, | 独立样本,总体正态,总体方差相等(但未知) |
| 差值均值(mean difference)(配对比较检验(paired comparisons test),非独立样本) | t,(n = 配对数) | 观测值成对,差值服从正态分布(normal distribution) | |
| 单个方差(variance) | 卡方(chi-square), | 总体正态 | |
| 两个方差是否相等 | (较大的方差放在分子) | F, 和 | 总体正态,独立样本 |
| **相关性(correlation)**是否为零 | t, | 变量服从正态分布 |
均值之差与配对比较
- 独立样本(independent samples)(如小盘基金的收益率与大盘基金的收益率):用均值之差 t 检验(t-test)检验 ,df 。这个自由度属于**合并(pooled)**版本:它假定两个总体(population)方差相等,把两个样本合在一起估计一个方差 。不假定方差相等的检验用非合并标准误(standard error),自由度另用 Welch 近似计算,通常小于 。当 时,合并与非合并的标准误完全相同;样本方差(sample variance)相近时,两个 t 值也很接近。
- 考试惯例:均值之差的统计量可以用非合并标准误 计算,仍与 个自由度的 t 临界值比较。
- 现行做法: 个自由度配合并标准误(假定方差相等);非合并(Welch)检验的自由度更少。
- 非独立样本(dependent samples)(同一批对象测量两次,如每只基金降费前后的收益率):先算出每一对的差值,再对这些差值做单个均值的检验。这就是配对比较检验(paired comparisons test),df 。
例(独立样本): ,,;,,。假定总体方差相等,,;df = 54,5% 双尾临界值为 2.005,所以不能拒绝均值相等的原假设(null hypothesis, H0)。(用非合并标准误得 ,结论相同。) 例(配对): 16 对数据,,,。它超过 ,所以拒绝差值均值为零的原假设。
单个方差的检验(卡方)
**卡方分布(chi-square distribution)**不对称(右偏),下限为零。在 水平上做双尾检验(two-tailed test),要找一个下侧临界值(其右边的面积为 )和一个上侧临界值(其右边的面积为 )。 例: 21 个观测值,,,。自由度为 20、 时,临界值为 9.591 和 34.170,所以不能拒绝原假设。
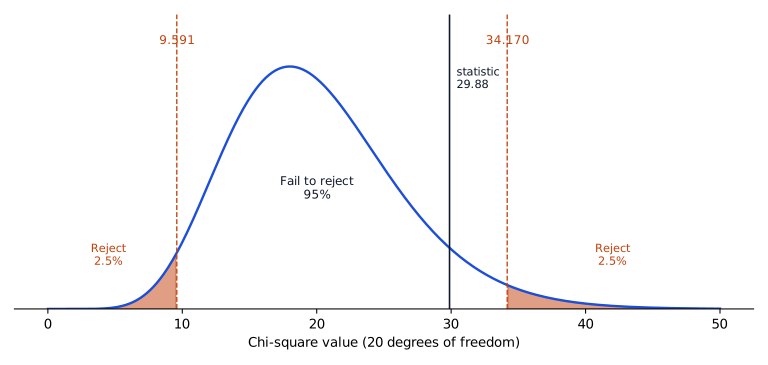
关于标准差(standard deviation)的假设要改写成关于方差的假设。收益率用小数表示时,“ 低于 3%”的说法写成 对 ,只用下侧临界值。
两个方差的检验:F 检验(F-test)
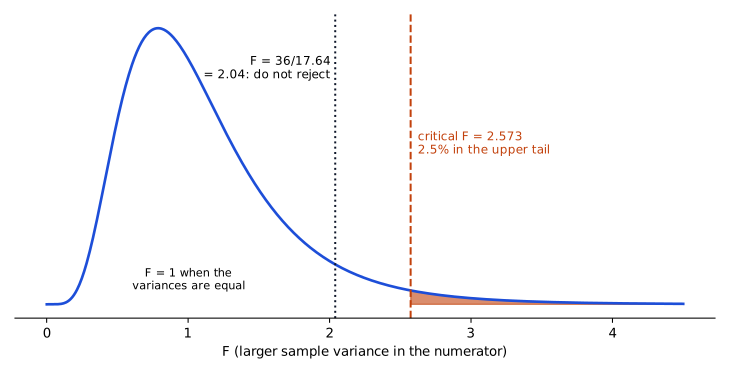
**F 分布(F-distribution)**右偏,下限为零,由两个自由度决定(分子 ,分母 )。样本方差相等时 。把较大的方差放在分子上,就只需要看上侧临界值(双尾检验时该尾部面积为 )。
- (方差没有差异)对 。
- F 统计量超过 F 临界值时,拒绝 ,结论是方差存在显著差异。 例: (),(),。上侧尾部 2.5% 的临界值 为 2.573,所以不能拒绝原假设。
相关系数的检验
相关系数(correlation coefficient)(即皮尔逊相关系数(Pearson correlation))衡量线性关系的强弱,取值在 −1(完全负相关)和 +1(完全正相关)之间;为零表示没有线性关系。 对 。统计量只需要样本相关系数 和样本容量 ;它服从自由度为 的 t 分布(t-distribution)。统计量的绝对值随 和 增大,所以大样本中不太强的相关性(correlation)也可能显著:同样是 ,(),而小样本只有 ()。
例: ,,。它超过 ,所以拒绝 。
给出表格时,按 个自由度选行,按题目给定的(双尾)显著性水平选列。只有 超过该列的值,才能在该水平上拒绝原假设。
p 值与 p 值操纵
**p 值(p-value)**是能够拒绝原假设的最小显著性水平(即在 为真时,得到至少与观测值一样极端的统计量的概率)。拒绝 的条件是 p 值 < 。 **p 值操纵(p-hacking)**是指操纵数据或检验过程,人为制造统计上显著的结果,例如:
- 只检验表现最好的时期,或把不利的观测值当作“异常值(outliers)”删掉;
- 数据挖掘(data mining):反复做很多检验,直到有一个拒绝原假设( 时,对为真的原假设做 20 次检验,大约有 1 次会因偶然而拒绝);
- 用平滑过的数据(如基于评估值的数据)低估风险。
p 值操纵会让实际为真的原假设被拒绝,因此提高了第一类错误(Type I errors)(假阳性)的频率。它不同于正当地选择显著性水平或寻找功效更强的检验。
常见考试陷阱
- 自由度:相关性(correlation)检验为 ;单个均值、配对检验和单个方差(variance)为 ;均值之差为 (合并,假定总体方差相等);F 检验为 。
- 卡方检验一个方差(variance);F 检验两个方差;t 检验均值和相关性(correlation)。
- 同一批对象测量两次,要用配对比较检验(paired comparisons test),不用均值之差检验。
- F 检验中拒绝 ,结论是方差(variance)不同。
答题技巧
- 按检验对象选检验:均值在总体方差未知时用 t(已知时用 z,大样本时也可用 z 近似);检验相关性是否为零,两个变量都服从正态分布时用 t;一个方差用卡方;两个方差用 F。
- F 统计量的分子放较大的方差,就只需要上侧临界值。
- 题目给出 p 值时,拒绝 的条件是 p 值低于 ,不需要临界值。
本节要点
- 方差(variance)相等的独立样本,用合并的均值之差 t 检验,自由度为 ;同一批对象测量两次,用配对比较检验(paired comparisons test),自由度为 。
- 单个方差(variance)用 检验,自由度为 ;卡方分布右偏,下限为零。
- 两个方差(variance)用 检验,自由度为 和 。
- 相关性(correlation)用 检验,自由度为 ;统计量的绝对值随 和 上升。
- p 值是能够拒绝 的最小显著性水平。
- p 值操纵会提高第一类错误(Type I errors)的频率。
随堂小测
An analyst tests whether a currency strategy's mean daily return is zero and obtains a p-value of 0.021. Which conclusion is most accurate?
查看答案和解析
正确答案: C
p 值是能够拒绝原假设的最小显著性水平。只要选定的 α 大于 p 值,就拒绝原假设,所以本题在 5% 或 2.5% 的水平上拒绝,在 1% 的水平上不拒绝。
其他选项为什么错
- A. 在 1% 水平上,p 值 0.021 高于 α = 0.01,所以不能拒绝原假设。
- B. p 值是在假定原假设为真的前提下算出的:它是在 下得到至少与观测值一样极端的检验统计量(test statistic)的概率。它不衡量 本身为真的概率。
本题要点 p 值低于 α 时拒绝 。p 值为 0.021,在 5% 水平上拒绝,在 1% 水平上不拒绝。
模块 7.4
非参数假设检验(Nonparametric Hypothesis Tests)
LOS 7.c — 参数检验与非参数检验
什么样的检验是非参数检验?
| 参数检验(Parametric test) | 非参数检验(Nonparametric test) | |
|---|---|---|
| 检验对象 | 分布的某个参数(parameter)(均值、方差、相关性(correlation)) | 不是参数的东西(秩、各类别的计数),或者假定不成立时的参数 |
| 假定 | 特定的分布(如总体(population)服从正态分布(normal distribution)) | 很少或没有分布假定 |
| 典型数据 | 按刻度测量的数值 | 秩或类别数据 |
| 准确性 | 假定成立时往往更准确 | 更灵活,但在参数检验的假定成立时往往不如参数检验准确 |
以下情况用非参数检验(Nonparametric test):(1)数据是秩或类别;(2)参数检验的分布假定不成立(如样本(sample)小、总体明显非正态,不能依靠中心极限定理(central limit theorem, CLT));(3)问题本身与参数无关,例如两组秩是否相关,或一组观测值是否符合某个特定分布。
斯皮尔曼秩相关检验
**斯皮尔曼秩相关系数(Spearman rank correlation)**衡量两组秩之间单调关系的强弱(如一只基金今年和明年的业绩排名)。秩为整数, = 第 项的两个秩之差:
核心概念
例: 六只基金的秩差分别为 1、−1、0、2、−1 和 −1,,。
显著性检验用与皮尔逊相关系数相同的统计量 ,大样本()时服从自由度为 的 t 分布。所以,检验业绩排名是否持续,是一种非参数检验。
用列联表做独立性检验
**列联表(contingency table)**按两个类别特征对观测值计数(如发行人(issuer)行业 × 信用评级变动)。**卡方独立性检验(chi-square test of independence)**判断这两个特征是否相关。
- :两个特征相互独立。:两者不独立。
- 独立时单元格 的期望频数(expected frequency)。两个特征独立时,一个观测值落在哪一行,对它落在哪一列没有任何信息,所以每一行的合计按各列合计的比例分配到各列:
- 检验统计量(test statistic)(对所有单元格的离差平方求和,每一项都除以期望频数):
- 超过卡方临界值(critical value)时拒绝独立性(只看右尾)。
- 单元格的标准化残差(standardized residual)(皮尔逊残差)为 ;它的平方就是该单元格对 的贡献。
- 考试惯例:每个标准化残差近似服从标准正态分布(standard normal distribution),数值超出 ±2 的单元格被标记为对不独立有显著贡献。
- 现行做法:行合计和列合计都是从数据中估计的,所以原始残差的方差(variance)小于 1,±2 只能作为筛选用的经验法则。调整残差把 除以 ,近似服从标准正态分布的是它。
例: 220 只债券的样本,按发行人规模和一年内的评级行动分类:
| 发行人规模 | 上调 | 不变 | 下调 | 合计 |
|---|---|---|---|---|
| 小型 | 42 | 38 | 20 | 100 |
| 大型 | 18 | 62 | 40 | 120 |
| 合计 | 60 | 100 | 60 | 220 |
(小型,上调)的期望频数 。对六个单元格的 求和,得到 ,自由度为 。5% 的临界值为 5.991(1%:9.210),所以拒绝独立性。(小型,上调)的标准化残差为 :按 ±2 的经验法则,小型发行人被上调的频率明显高于独立时应有的水平。
常见考试陷阱
- 列联表(contingency table)的自由度为 ;常见错误是 和 。只数类别的行和列,不算“合计”行和列。上面 2 × 3 的债券表,自由度为 2; 得 3, 得 6。
- 期望频数来自行合计和列合计,而不是来自观测到的单元格。
- 统计量要把每个离差平方除以期望频数;离差直接相加,结果总是零。
- 秩数据(如业绩排名)用非参数的斯皮尔曼检验;类别计数用列联表上的卡方检验(chi-square test)。
- 标准化残差逐个单元格按 ±2 的经验法则筛查,总体统计量则与卡方临界值(critical value)比较。
答题技巧
- 秩数据对应斯皮尔曼检验;类别计数对应列联表上的卡方检验。
- 列联表的自由度为 ,只数类别的行和列,不算合计。
本节要点
- 非参数检验(Nonparametric test)用于秩或类别数据、参数检验的假定不成立,或者问题与参数无关的情形。
- 斯皮尔曼秩相关系数为 ,大样本()时用与皮尔逊相关系数相同的 t 统计量检验。
- 卡方独立性检验中,期望频数 = 行合计 × 列合计 ÷ 总数,,自由度为 ,只用右尾。
- 标准化残差为 ,按经验法则,超过 ±2 的单元格被标记出来。
随堂小测
A credit researcher compiles the following default data for bond issuers in three sectors:
| Sector | No default | Technical default | Actual default | Total |
|---|---|---|---|---|
| Energy | 94 | 16 | 15 | 125 |
| Healthcare | 108 | 9 | 13 | 130 |
| Utilities | 126 | 8 | 16 | 150 |
| Total | 328 | 33 | 44 | 405 |
Assuming sector and default status are independent, the expected number of energy issuers in technical default is closest to:
查看答案和解析
正确答案: A
两个特征独立时,单元格的期望频数 =(行合计 × 列合计)/ 观测值总数。能源行业发行人中处于技术性违约的单元格,用 Energy 行合计(125)和 Technical default 列合计(33)。
其他选项为什么错
- B. 约 14(13.6)用的是 Actual default(实际违约)列的合计(44),而不是 Technical default(技术性违约)列的合计:。
- C. 16 是能源行业发行人中处于技术性违约的观测数;题目问的是独立情况下的期望数。
本题要点 期望频数 = 行合计 × 列合计 / 总计。
练习题
A multi-asset portfolio is worth €40 million, and its daily returns have a standard deviation of 1.2%. Using the parametric method and assuming a daily mean return of zero, the portfolio's daily 5% value at risk (VaR) is closest to:
查看答案和解析
正确答案: A
参数法风险价值假定收益率服从正态分布。均值为零时,5% VaR 是低于均值 1.645 个标准差处的损失,整个 5% 都放在左侧尾部。它的意思是:任何一天亏损这个金额或更多的概率为 5%。
5% 的单尾临界值:(精确值 1.6449;很多教材取整为 1.65)。
(用 1.65 得 €792,000,仍然最接近 €0.79 million。)
其他选项为什么错
- B. €0.94 million 用的是 1.96,即双尾 5% 的值(每侧 2.5%)。VaR 是单尾的,整个 5% 都放在一侧(z = 1.645)。
- C. €1.12 million 用的是 2.33,即 1% 的单尾临界值,算出的是 1% VaR。
本题要点 VaR 把整个 放在一侧尾部:10% 用 1.28,5% 用 1.645,1% 用 2.33。它是该概率下的最小损失;更大的损失仍可能发生。
本章题库共 67 道题。 去题库全部练习。
本章要点
- 先把总体分组,再在每一组内随机抽样,就是分层随机抽样。
- VaR 把整个 放在一侧尾部:10% 用 1.28,5% 用 1.645,1% 用 2.33。它是该概率下的最小损失;更大的损失仍可能发生。
- 固定时, 越低, 越高,功效越低。
- p 值低于 α 时拒绝 。p 值为 0.021,在 5% 水平上拒绝,在 1% 水平上不拒绝。
- 期望频数 = 行合计 × 列合计 / 总计。