数量方法 · 第 5 章
资产收益率的统计特征(Statistical Characteristics of Asset Returns)
CFA 一级 · 数量方法 · 第 5 章 · 约 58 分钟
本章学习目标
- LOS 5.a 计算、解读和评价集中趋势与位置指标(均值、中位数、众数、截尾均值和缩尾均值、分位数),并判断哪种指标适合给定的数据。
- LOS 5.b 描述、解读和评价偏度与峰度,以及它们对收益率分布的均值、中位数、众数和尾部风险的影响。
- LOS 5.c 计算、解读和评价协方差与相关性,包括相关性的局限(只反映线性关系、不代表因果关系、伪相关)以及散点图的用法。
- LOS 5.d 计算、解读和评价半方差、目标下行偏差和变异系数,用它们衡量下行风险和相对风险。
模块 5.1
集中趋势指标(Measures of Central Tendency)
本章用集中趋势指标(measures of central tendency)和位置指标(measures of location)概括收益率分布,包括均值(mean)、中位数(median)、众数(mode)、截尾均值(trimmed mean)、缩尾均值(winsorized mean)和分位数(quantile);再用离散程度(dispersion)指标描述分布,包括极差(range)、平均绝对偏差(mean absolute deviation, MAD)、方差(variance)和标准差(standard deviation);并解读偏度(skewness)和峰度(kurtosis)。随后计算两个变量的协方差(covariance)和相关性(correlation),用目标下行偏差(target downside deviation)衡量下行风险,用变异系数(coefficient of variation, CV)衡量相对离散程度。
LOS 5.a — 集中趋势与位置(Central tendency and location)
集中趋势指标(Measures of Central Tendency)概括数据集的“中心”在哪里,用一个数代表典型值或期望值(expected value)。位置指标(分位数)描述某个观测值在分布中所处的位置。
总体与样本
**总体(population)**是所关心的全部个体(例如某基金有史以来的全部月度收益率)。**样本(sample)**是总体的一个子集(例如最近 36 个月)。用样本统计量推断总体参数。在所有集中趋势指标中,分析师最常用算术平均数(arithmetic mean)。
三个经典指标
核心概念
| 指标 | 定义 | 是否受异常值(outliers)影响? | 说明 |
|---|---|---|---|
| 算术平均数 | 观测值之和除以观测值个数(每个值权重相同) | 是;一个极端值就可能让它大幅变动 | **样本均值(sample mean)**就是算术平均数 |
| 中位数 | 数据排序后位于中间的值;个数为偶数时,取中间两个值的平均 | 否;它是稳健估计量(robust estimator)(有异常值,或数据来自与假设不同的分布时,结果仍然可靠) | 一半观测值在它之上,一半在它之下 |
| 众数 | 出现次数最多的值 | 否 | 一个数据集可以有一个众数、两个众数(双峰(bimodal))、多个众数,也可以没有众数 |
收益率这类连续数据很少出现完全相同的值,所以先把结果分到若干区间,再报告众数区间(modal interval),即包含观测值最多的区间。
**几何平均数(geometric mean)**衡量收益率的复合增长率。它和算术平均数一样用到每个观测值,所以也会被极端值拉动。
例: 六个月的月度收益率:4%、−1%、7%、4%、2%、20%。
- 均值 。
- 排序:−1、2、4、4、7、20,所以中位数(median) 。
- 众数(mode) (出现两次)。
单独一个 20% 的月份把均值拉到中位数和众数之上。把 20% 换成 9%,均值降到 4.17%,中位数和众数仍是 4%。
异常值的处理
异常值是异常大或异常小的观测值。它可能来自测量、录入或抽样误差,也可能只是数据本身的真实波动。如果是错误,它会扭曲均值。如果数据测量无误,保留全部数值可能更好,因为删掉真实的观测值会丢掉分布的信息。
- 截尾均值:按设定比例剔除两端的极端观测值(两端各占一半),再对剩下的值求平均。截尾识别异常值的方法客观,但可能丢掉有用的信息。4% 截尾均值剔除最低的 2% 和最高的 2%。分母是剩下的观测值个数。
- 缩尾均值:保留所有观测值,但用百分位数(percentile)的值替换极端值。算 96% 缩尾均值时,低于第 2 百分位数的值设为第 2 百分位数的值,高于第 98 百分位数的值设为第 98 百分位数的值;然后对全部 个值求均值。
核心概念
| 截尾均值 | 缩尾均值 | |
|---|---|---|
| 极端值 | 剔除 | 用百分位数的值替换 |
| 参与平均的值的个数 | 少于 | 全部 个 |
| 保留的信息 | 较少 | 较多 |
异常值只有少数几个时,缩尾均值比算术平均数或截尾均值更能代表中心。两种调整都会让估计值远离极端值所在的一侧:少数几个很大的正值会让截尾/缩尾均值低于算术平均数;少数几个很大的负值会让它高于算术平均数。
分位数
分位数是一个分界值:给定比例的观测值小于或等于它。中位数是第 50 百分位数,也是第二个四分位数(quartile)和第五个十分位数(decile)。
核心概念
| 分位数 | 把数据分成 | 例子 |
|---|---|---|
| 四分位数 | 4 份 | 第 3 四分位数 = 第 75 百分位数 |
| 五分位数(quintile) | 5 份 | 第 1 五分位数 = 第 20 百分位数 |
| 十分位数 | 10 份 | 第 9 十分位数 = 第 90 百分位数 |
| 百分位数 | 100 份 | 位于第 70 百分位数的观测值,有 70% 的观测值低于它 |
每个分位数都按“小于或等于它的观测值占比”命名,所以位置顺序固定:第一个十分位数(第 10 百分位数)、第一个五分位数(第 20)、第一个四分位数(第 25)、中位数(第 50)。较低位置的分位数可以等于、但绝不会超过较高位置的分位数。
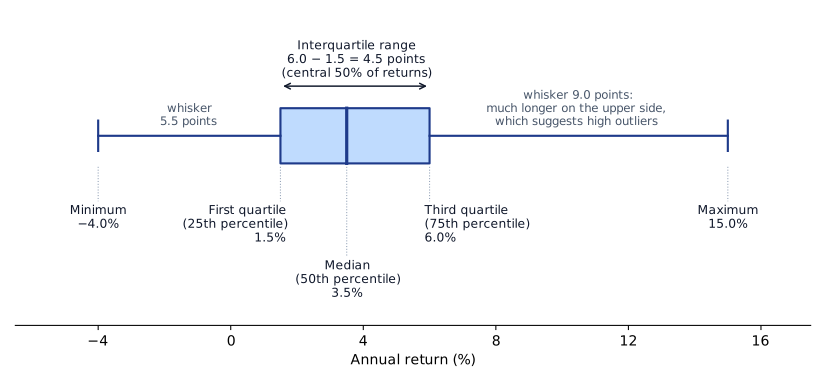
**四分位距(interquartile range, IQR)**从第一个四分位数(第 25 百分位数)到第三个四分位数(第 75 百分位数),宽度为 。它包含中间 50% 的数据。
**箱线图(box and whisker plot)**画一个跨越四分位距的箱子,箱内一条线标出中位数,须线延伸到最小和最大观测值(即整个极差)。某一侧的须线明显更长,提示那一侧有异常值。
平稳性
数据**平稳(stationary)时统计推断效果最好:其背后分布的均值和方差(variance)不随时间变化。如果均值和方差会变,序列就是非平稳(nonstationary)**的,基于它的预测或检验就不那么可靠。向上有趋势的价格或指数水平值通常是非平稳的;它们按期计算的百分比变动平稳的可能性要大得多。
常见考试陷阱
- 把排序后数据的中间值叫作均值。它是中位数(median);个数为偶数时,取中间两个值的平均。
- 以为等于中位数(median)的值也等于均值。两者可能接近但不相等,先算出均值再选。
- 以为只改变最大(或最小)观测值时中位数(median)会变。只要这个值的排位不变,变的只有均值。
- 算 X% 截尾均值时从两端各剔除 X%。正确做法是从每一端剔除 X/2%。
- 把缩尾均值当成剔除了极端值(个数仍是 ),或者把百分位数理解为高于该值的观测值占比。
- 把平稳性和“均值等于中位数(median)”或“均值等于几何平均数(geometric mean)”联系起来。平稳性说的是均值和方差(variance)在时间上保持稳定。
答题技巧
- 只改变最大或最小的观测值,均值会变,中位数不变,前提是这个值的排位不变。
- 分位数的位置顺序固定(第一个十分位数、第一个五分位数、第一个四分位数、中位数),把较低分位数排在较高分位数之上的选项可以直接排除。
- 少数几个很大的正值会让截尾均值和缩尾均值低于算术平均数,少数几个很大的负值会让它们高于算术平均数。
本节要点
- 算术平均数给每个观测值相同的权重,受异常值影响;中位数(median)是排序后数据的中间值(个数为偶数时取中间两个值的平均),是稳健估计量。
- 众数是出现次数最多的值;数据集可以有一个众数、两个众数(双峰)、多个众数或没有众数;连续数据报告众数区间。
- 截尾均值按设定比例剔除两端的极端观测值(两端各占一半),再对其余的值求平均;缩尾均值用百分位数的值替换极端值,再对全部 个观测值求平均。
- 异常值只有少数几个时,缩尾均值比算术平均数或截尾均值更能衡量中心。
- 分位数是一个分界值,给定比例的观测值小于或等于它;四分位距 包含中间 50% 的数据。
- 平稳数据的均值和方差(variance)不随时间变化;有趋势的价格水平值通常是非平稳的,而它们按期计算的百分比变动平稳的可能性大得多。
随堂小测
The table below shows one-year returns for seven equity funds.
| Fund | Return (%) |
|---|---|
| Harbor Growth | 5 |
| Juniper Value | 11 |
| Lakeview Income | 10 |
| Meridian Core | 11 |
| Northgate Select | 15 |
| Oakmont Small Cap | 3 |
| Pinecrest Global | 17 |
Which of the following statements about these returns is most accurate?
查看答案和解析
正确答案: C
排序后的收益率为 3、5、10、11、11、15、17。中间(第四个)值是 11%,而 11% 也是唯一出现两次的值,所以中位数(median)和众数(mode)都是 11%。均值更低,约为 10.29%。
排序:3、5、10、11、11、15、17。第四个值就是中位数,。
众数 (出现两次)。
其他选项为什么错
- A. 均值(10.29%)低于中位数(11%),因为 3% 和 5% 这两个低收益率把平均值拉低了。
- B. 均值(10.29%)不等于众数(11%)。
本题要点 三个指标都要实际算出来;均值很少恰好等于某个观测值。
模块 5.2
离散程度、偏度与峰度(Dispersion, Skewness, and Kurtosis)
LOS 5.a — 离散程度指标
**离散程度(dispersion)**是观测值围绕其集中趋势的波动。在投资中,集中趋势衡量回报,离散程度衡量风险。
极差与平均绝对偏差
**极差(range)**计算简单,但它只用到最极端的两个观测值,看不出两者之间的数值如何分布。
**平均绝对偏差(mean absolute deviation, MAD)**是各观测值与算术平均数(arithmetic mean)距离的平均,不考虑正负号:
必须取绝对值,因为与均值的原始偏差加总后总是为零。MAD 为 5%,表示观测值平均偏离均值 5 个百分点。中位数绝对偏差(median absolute deviation) 是更稳健的替代指标。
方差与标准差
方差(variance)是与均值偏差的平方的平均;平方消除了正负号,但会放大异常值(outliers),所以方差对异常值敏感。对资产收益率来说,方差越高,风险越大。方差的正平方根就是标准差(standard deviation),它和数据的单位相同(方差的单位是平方单位,例如“百分比的平方”)。
核心概念
| 总体(population) | 样本(sample) | |
|---|---|---|
| 方差 | ||
| 标准差 |
样本方差(sample variance)用 而不用 ,这叫作贝塞尔校正(Bessel's correction)。除以 会系统性地低估总体(population)方差(小样本时尤其明显),成为有偏估计量(biased estimator)。除以 后, 是 的无偏估计量(unbiased estimator)。考试惯例:样本标准差 也被说成 的无偏估计量。现行做法: 是 的标准估计,但无偏方差估计值的平方根略微向下偏;除非样本非常小,这个影响很小。
例: 一个含四个年收益率的样本:10%、4%、−2%、12%。
- 均值 。偏差:4、−2、−8、6(合计 )。
- MAD 。
- 偏差平方和 。
- 样本方差 ;样本标准差 。
- 如果这些数据是整个总体:,。
- 极差 个百分点。
计算器(TI BA II Plus): [2ND][DATA],输入 X01 = 10、X02 = 4、X03 = −2、X04 = 12;[2ND][STAT](1-V)后向下翻:,(样本),(总体)。
随时间缩放
按照时间平方根法则(root of time law),收益率相互独立时,方差随期间长度线性增长:日方差为 时, 天的方差为 ,标准差为 。实际中,长期限的方差往往低于这条法则的预测。
LOS 5.b — 偏度与峰度
偏度
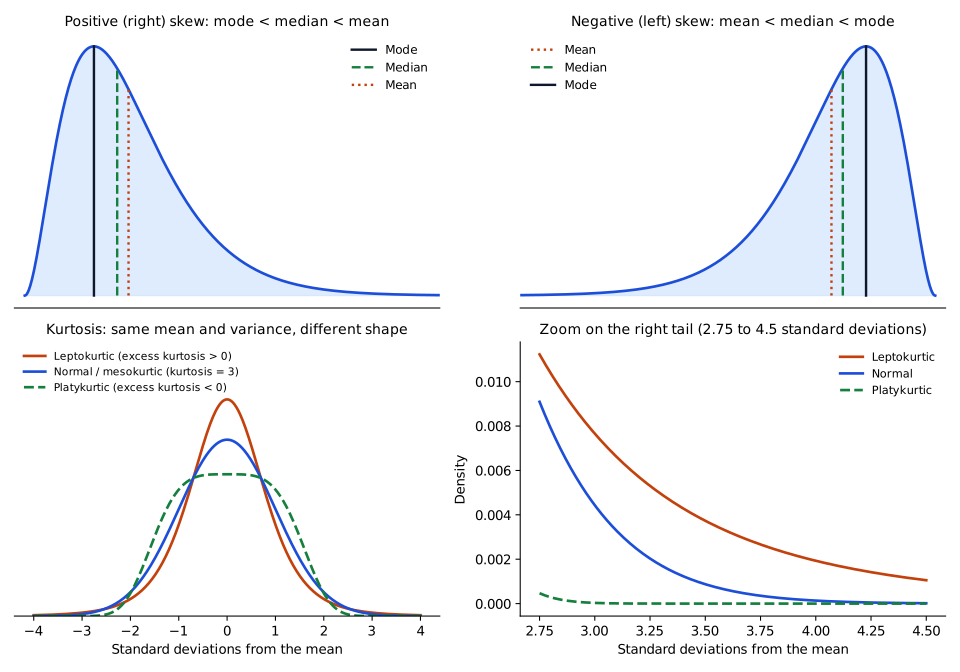
**对称(symmetrical)**分布在均值两侧形状相同,均值、中位数(median)和众数(mode)相等。分布对称时,某个亏损区间(例如零均值附近的 −6% 到 −4%)出现的频率,和对应的盈利区间(+4% 到 +6%)一样。**偏度(skewness)**衡量分布不对称的程度。
核心概念
| 形状 | 长尾 | 集中趋势指标的大小顺序 | 样本偏度 |
|---|---|---|---|
| 对称 | 无 | 均值 = 中位数 = 众数 | 0 |
| 正偏(positively skewed)(右偏) | 右侧(很大的正异常值) | 众数 < 中位数 < 均值 | > 0 |
| 负偏(negatively skewed)(左偏) | 左侧(很大的负异常值) | 均值 < 中位数 < 众数 | < 0 |
均值受异常值影响最大,所以会被拉向长尾一侧。在有偏的单峰(unimodal)分布中,中位数位于众数和均值之间。对收益率来说,正偏意味着超过一半的期间收益低于均值(中位数低于均值),而少数期间带来很大的收益。负偏正好相反:多数期间收益高于均值,偶尔出现的大额亏损把均值拉低。样本偏度是标准化偏差(standardized deviations)三次方的平均,其中 是样本标准差(LOS 要求的是解读,不是计算):
右偏数据的样本偏度为正,因为高于均值的偏差平均更大。判断偏斜方向有个快捷办法:比较众数(峰值)到极差(range)两端的距离,较长的一侧就是尾部。
峰度
**峰度(kurtosis)**衡量分布相对于正态分布(normal distribution)(峰度 )有多尖、尾部有多厚。超额峰度(excess kurtosis) 峰度 。峰度使用标准化偏差的四次方:
核心概念
| 术语 | 峰度 | 超额峰度 | 与正态分布相比的形状 |
|---|---|---|---|
| 尖峰厚尾(leptokurtic) | > 3 | > 0(正) | 更尖、尾部更厚:与均值的小偏差更多,很大的偏差也更多 |
| 中峰(mesokurtic) | = 3 | = 0 | 与正态分布相同 |
| 低峰薄尾(platykurtic) | < 3 | < 0(负) | 更平(峰较低),尾部更薄 |
厚尾(fat tails)关系到风险:尖峰厚尾(leptokurtic)的收益率分布出现极端结果(大额收益和大额亏损都有)的频率,高于正态模型的预测。实际资产收益率往往既有偏度,又有超额峰度,所以假设正态分布的风险模型会低估极端亏损的概率。一般来说,负偏越严重、超额峰度越大,风险都越大。
常见考试陷阱
- 数据是样本(sample)却除以 ,或数据是整个总体(population)却除以 。对上面四个样本收益率,除以 4 得到的标准差(standard deviation)是 5.48%,而不是 6.32%。
- MAD 除以 ,或者对带正负号的偏差求平均(它们加总总是为零)。在上例中会得到 ,而不是 5.0%。
- 题目问标准差(方差的平方根),却停在方差(variance)。在上例中会答成 40(%²),而不是 6.32%。
- 把峰度(kurtosis)和 0 比较,而不是和 3 比较(只有超额峰度才和 0 比较)。峰度为 2.5 时,虽然数字为正,分布仍是低峰薄尾(platykurtic)。
- 把均值放错一侧:正偏时均值是三个指标中最大的,负偏时是最小的。
- 把一个很低的异常值(例如一个很差的分数)当成正偏。它造成的是负偏,并把均值拉到中位数之下。
答题技巧
- 在有偏的单峰分布中,中位数位于众数和均值之间,均值在长尾一侧,所以偏斜方向一确定,三个指标的大小顺序也就确定了。
本节要点
- 极差(range)是最大值减最小值,只用到两个极端观测值;平均绝对偏差 是与均值的偏差(不计正负号)的平均。
- 样本方差(sample variance)用与均值偏差的平方和除以 (贝塞尔校正),这样 是 的无偏估计量;总体(population)方差除以 。
- 方差(variance)的正平方根是标准差(standard deviation),它和数据的单位相同,而方差是平方单位。
- 按照时间平方根法则,收益率相互独立时, 个期间的方差(variance)为 ,标准差(standard deviation)为 ,但实际中长期限的方差往往更低。
- 正偏分布有一条长的右尾,众数 < 中位数 < 均值;负偏分布有一条长的左尾,均值 < 中位数 < 众数;对称分布三者相等。
- 正态分布的峰度为 3;超额峰度(excess kurtosis) = 峰度 − 3;尖峰厚尾(leptokurtic)分布(峰度高于 3)尾部更厚;负偏越严重、超额峰度越大,风险都越大。
随堂小测
A histogram of a biotech fund's daily returns shows a long tail stretching to the right, created by a few very large gains. For this unimodal distribution, which relationship among the measures of central tendency is most likely?
查看答案和解析
正确答案: C
长的右尾说明分布正偏。很大的正异常值把均值拉高得最多,中位数次之,众数(峰值)完全不动,所以均值 > 中位数 > 众数。
其他选项为什么错
- A. 这个顺序描述的是有一条长左尾的负偏分布。
- B. 三个指标相等描述的是对称分布,对称分布没有长尾。
本题要点 正偏(右偏):众数 < 中位数 < 均值。
模块 5.3
协方差、相关性与其他离散程度指标(Covariance, Correlation, and Alternative Measures of Dispersion)
LOS 5.c — 协方差与相关性
散点图
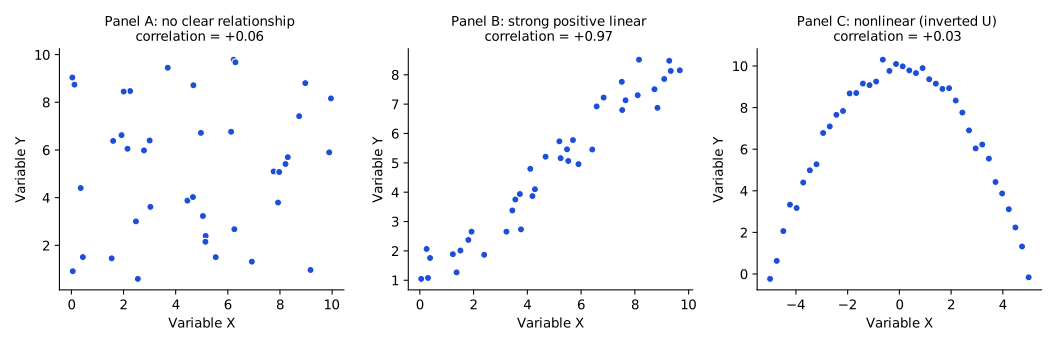
**散点图(scatter plot)把两个变量的成对观测值画在图上,每个变量对应一条坐标轴。它能让人一眼看出两个变量是否同向变动,关系是否大致呈直线,以及是否存在相关系数(correlation coefficient)反映不出来的非线性(nonlinear)**关系。
协方差
**协方差(covariance)**衡量两个变量如何共同变动:
(总体(population)版本使用总体均值,并除以 。)协方差为正,说明两个变量往往同时高于(或低于)各自的均值;协方差为负,说明它们往往反向变动。
例: 基金 X 的四个年收益率为 6%、−2%、10% 和 2%,基金 Y 为 5%、1%、9% 和 1%。两者的均值都是 4%。
- 与均值的偏差(百分点):基金 X 为 2、−6、6、−2;基金 Y 为 1、−3、5、−3。
- 把每一对偏差相乘再加总:。
- 除以 :(%²)。
每个交叉乘积都是正的,所以两只基金在相同的年份同时高于或低于各自的均值。
协方差不好解读:它的大小取决于数据的单位,单位又是两个变量单位的乘积(例如百分比的平方)。协方差为 30,只说明共同变动的方向,说明不了强度。协方差没有上限,也没有下限。一个变量与自身的协方差就是它的方差(variance):。
相关性
相关系数(相关性(correlation))用两个标准差(standard deviation)对协方差做标准化:
核心概念
这里 和 是样本标准差。总体版本以同样方式使用 和 。
核心概念
| 取值 | 含义 |
|---|---|
| 完全正相关(perfect positive correlation):与均值的偏差同方向、严格按比例变动;所有点都落在同一条向上倾斜的直线上,不论直线陡峭还是平缓 | |
| 正向线性关联; 越接近 1,关联越强 | |
| 没有线性关系(no linear relationship) | |
| 负向线性关联 | |
| 完全负相关(perfect negative correlation):所有点都落在同一条向下倾斜的直线上 |
相关系数没有单位,总是在 −1 和 +1 之间。它不是概率: 并不表示“两个变量反向变动的概率是 60%”。由于协方差要除以两个标准差,在协方差不变而标准差缩小时,相关系数会离零更远。
例: 两只基金收益率的方差分别为 0.0036 和 0.0100,协方差为 0.0021。标准差分别为 和 ,所以
这是正向但不强的线性关联。必须先把方差换算成标准差。
对协方差例子中四年的基金收益率,,,所以 ,属于很强的正向线性关联。
相关性的局限
- 相关不等于因果(correlation is not causation)。相关性很强,并不说明一个变量驱动另一个变量,也说明不了因果关系的方向。只能说两个变量存在正向(或负向)关联(association),原因要另外研究。
- **异常值(outliers)**可能制造出相关性,也可能抹掉相关性;要检查剔除异常值后结果是否明显改变,以及这些异常值是信息还是噪声(noise)。
- **伪相关(spurious correlation)**是偶然产生的相关性,或者因为两个变量都与第三个变量有关而产生的相关性(例如两个序列都随通货膨胀(inflation)或人口增长而上升),两者之间并没有因果联系。
LOS 5.d — 下行风险与相对离散程度
半方差与目标下行偏差
方差和标准差对高于均值和低于均值的偏差一视同仁。有些情况下,只计入低于均值或低于某个设定目标的结果更有用,这衡量的是下行风险(downside risk)。
- 半方差(semivariance):只用低于均值的结果计算的方差。把低于均值的观测值的偏差平方加总,再除以样本(sample)容量:
它的平方根是半标准差(semideviation),是标准差在下行方向上的对应指标。
- 目标下行偏差(target downside deviation)(也叫目标半标准差(target semideviation)):和标准差类似,但只有低于设定目标 的结果计入;分母仍是整个样本容量减一:
例: 五个年收益率:12%、−4%、7%、3%、10%;目标为 6%。只有 −4% 和 3% 低于目标:差额的平方 。。把目标提高到 8%,7% 的收益率也被计入,另外两个差额也变大:。提高目标绝不会降低目标下行偏差。
变异系数
均值收益率相差很大的资产,直接比较标准差可能产生误导。**相对离散程度(relative dispersion)**指标用均值对风险做缩放。**变异系数(coefficient of variation, CV)**为:
核心概念
它衡量每单位平均收益率承担的风险(risk per unit of mean return),所以 CV 越低越好(每单位收益率承担的风险更少)。它是两个同单位数值之比,所以没有单位,可以写成小数,也可以写成百分比。夏普比率(Sharpe ratio,见 Reading 8)把 CV 倒过来:用超过无风险利率(risk-free rate)的超额收益率(excess return)除以标准差。无风险利率为零时,CV 就是夏普比率的倒数。题目给出夏普比率和无风险利率时,先求出 ,再除以均值。
例: 基金 M 的均值为 5%,标准差为 4%,所以 。基金 N 的均值为 11%,标准差为 7.7%,所以 。基金 N 的标准差更高,但 CV 更好(更低)。
| 指标 | 用到的数据 | 尺度 |
|---|---|---|
| 标准差 | 与均值的全部偏差 | 绝对(与数据单位相同) |
| 目标下行偏差 | 只用低于目标的差额 | 绝对 |
| 变异系数 | 标准差 ÷ 均值 | 相对(每单位收益率) |
常见考试陷阱
- 把 CV 倒过来算,或者用方差去算。CV 标准差 ÷ 均值;题目给的是方差时,先开平方。对基金 M,倒过来算得 ,用方差 16(%²)算得 3.20,正确答案是 0.80。
- 减去题目给出的无风险利率。CV 用的就是均值本身;超额收益率除以标准差是夏普类比率,是另一个指标。
- 把标准差最低的资产当成风险收益权衡最好的,或者把标准差最高的资产当成相对风险最高的。两者都要用 CV 判断。
- 用协方差(covariance)除以一个方差(斜率类比率)或除以两个方差的乘积,而不是除以两个标准差的乘积。在两只基金的例子中,,,正确答案是 0.35。
- 把接近零的相关系数当成两个变量无关的证据。它只排除了线性关系。
- 目标下行偏差(target downside deviation)除以低于目标的结果个数(或这个个数减一),而不是整个样本容量减一。在目标为 6% 的例子中,会得到 ,而正确答案是 。
答题技巧
- 无风险利率为零时,CV 是夏普比率的倒数,知道一个就能直接得出另一个。
- 目标提高,目标下行偏差不会变小;提高目标反而使它下降的选项可以排除。
本节要点
- 样本协方差(covariance)为 ;它的正负号显示共同变动的方向,但大小取决于单位,而且没有上限或下限。
- 相关系数 没有单位,在 −1 和 +1 之间, 表示没有线性关系。
- 相关不等于因果;异常值(outliers)可能制造或抹掉相关性(correlation);伪相关是偶然产生的,或者因为两个变量都与第三个变量有关。
- 散点图能显示相关系数反映不出来的非线性关系。
- 半方差只用低于均值的结果;目标下行偏差(target downside deviation)只用低于目标 的结果,但分母仍用整个样本容量减一。
- 变异系数(coefficient of variation, CV) 衡量每单位平均收益率承担的风险,没有单位,CV 越低越好。
随堂小测
The covariance between the returns on Norland Utilities and Quarry Point Materials is 21.6 (percent squared). The standard deviation of Norland's returns is 8% and that of Quarry Point's returns is 6%. The correlation coefficient of the two return series is closest to:
查看答案和解析
正确答案: B
相关系数把协方差(covariance)除以两个标准差的乘积,对协方差做标准化。
其他选项为什么错
- A. +0.34 是只用 Norland 的方差去除协方差()。
- C. +0.60 是只用 Quarry Point 的方差去除协方差()。
本题要点 ;只除以一个方差,得到的是斜率类比率。
练习题
Priya Raman plans to model the monthly percentage changes in a copper price index. Her statistical tests will be most reliable if the series is stationary, which means that:
查看答案和解析
正确答案: C
如果其背后分布的均值和方差(variance)不随时间变化,数据就是平稳的。这些特征发生变化时,序列就是非平稳的,用过去的数据推断未来结果就不可靠。所以分析师通常对百分比变动建模,而不是对有趋势的价格水平值建模。
其他选项为什么错
- A. 只有所有观测值都相同时,几何平均数(geometric mean)才等于算术平均数;这和平稳性无关。
- B. 中位数(median)总是在四分位距之内,均值通常也在,除非数据极度偏斜。这一点说明不了分布是否随时间保持稳定。
本题要点 平稳 = 均值和方差随时间保持稳定。价格水平值通常是非平稳的;收益率(百分比变动)更可能是平稳的。
A multi-asset portfolio produced the returns shown below over the last four years.
| Year | Return |
|---|---|
| 1 | 19.0% |
| 2 | 7.5% |
| 3 | −9.6% |
| 4 | 4.9% |
Treating these returns as a sample, their coefficient of variation is closest to:
查看答案和解析
正确答案: C
变异系数(coefficient of variation, CV)是样本标准差除以平均收益率。这些收益率是样本,所以标准差的分母用 。
均值 。
| 年份 | 收益率 | (收益率 − 5.45) |
|---|---|---|
| 1 | 19.0 | 183.60 |
| 2 | 7.5 | 4.20 |
| 3 | −9.6 | 226.50 |
| 4 | 4.9 | 0.30 |
| 合计 | 414.61 |
其他选项为什么错
- A. 0.46 把比率倒过来了:。
- B. 1.87 用的是总体(population)标准差,,得到 ;但题目要求把这些收益率当作样本。
本题要点 样本变异系数:先用 n − 1 算出 s,再除以均值。
本章题库共 60 道题。 去题库全部练习。
本章要点
- 三个指标都要实际算出来;均值很少恰好等于某个观测值。
- 平稳 = 均值和方差随时间保持稳定。价格水平值通常是非平稳的;收益率(百分比变动)更可能是平稳的。
- 正偏(右偏):众数 < 中位数 < 均值。
- ;只除以一个方差,得到的是斜率类比率。
- 样本变异系数:先用 n − 1 算出 s,再除以均值。